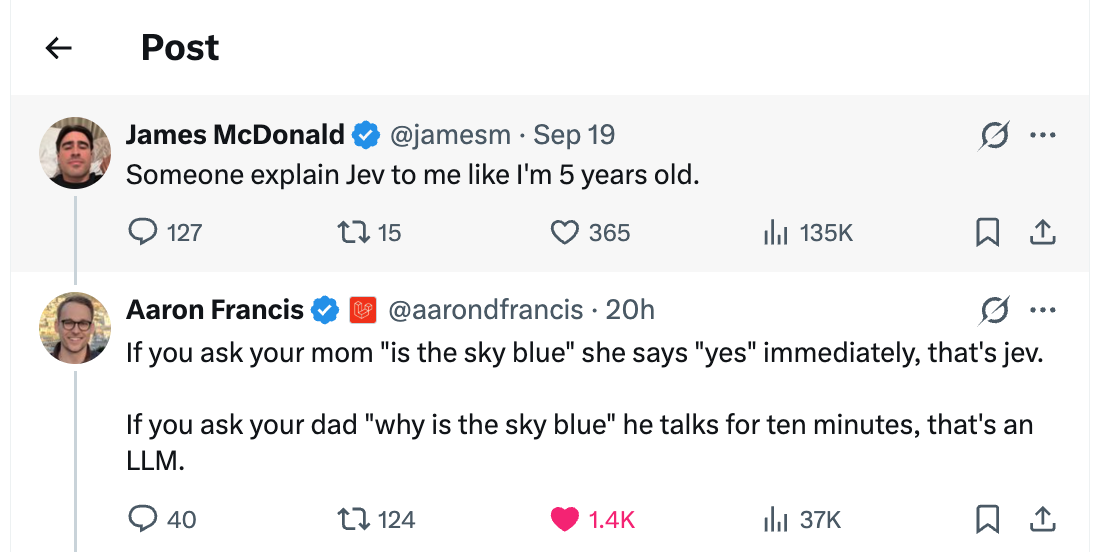
זה מודל החלטה בשני משפטים, מ-Aaron Francis בתגובה ל-James McDonald ב-X. כל שאר המאמר הוא אותה הבחנה, עם הספים, שמות הקבצים והמספרים.
מודל צ׳אט כותב את מה ש-Routines מכינה בשבילכם, את תקציר הבוקר, את סיכום הפגישה, את טיוטת הפוסט. המודל הזה הוא Claude או ChatGPT, או כל מה שאתם מגיעים אליו דרך OpenRouter. אתם מריצים אותו על החשבון שלכם, או על ה-AI ש-Routines מספקת. הכתיבה היא העבודה שהוא טוב בה. ארבע פעמים ביקשנו ממנו גם הכרעה: להמשיך או לעצור, עבר או נכשל, לשמור או למחוק, לתייק כאן או בשום מקום. הכרעה חמישית, האם פלט גמור שווה תג, מעולם לא הייתה קריאה למודל בכלל, רק בדיקת מילת מפתח. כל החמש עוברות עכשיו למודל החלטה שמחזיר הסתברות מכוילת ולא יודע לכתוב משפט: ארבע מהן בגרסה v1.6.0, שכבר יצאה, ובחירת התיקייה קודם לכן, בגרסה v1.5.15. המודל נקרא Jev, והוא של TypeSafe AI, לא שלנו.
חמשת המקומות שבהם היינו צריכים הכרעה
- שער על קשת בזרימה: האם הזרימה ממשיכה בקשת הזאת.
- בדיקה כפולה של פלט: האם הפלט הזה עומד ביעד שלו.
- בעלות על משימה מפגישה: הפעולה הזאת שלכם או שלהם.
- בחירת תיקייה לפגישה: לאיזו תיקייה בהערות שלכם הולכות הערות הפגישה האלה.
- תג ״דורש תשומת לב״: האם הפלט הזה שווה תג.
ארבעת הראשונים עובדים באותה צורה. אנחנו שואלים מודל צ׳אט את השאלה, אומרים לו לענות בפורמט קבוע, ומחזיקים מתחתיו עוד פיסת קוד שתחלץ את התשובה בריצות שבהן הוא ענה בפורמט אחר. פיסת הקוד הזאת היא הסימן: שילמנו לכותב שיעשה עבודה של שופט, ואז ניקינו אחריו. בלי כלים, בלי היסטוריית שיחה, רק השאלה, והאקראיות מונמכת כמעט עד הסוף. השער והבדיקה הכפולה רצים בשכבה המהירה ב-temperature: Some(0.0), הבעלות על המשימה ב-0.1, ובחירת התיקייה שכבה אחת מעל, ב-0.2.
החמישי מעולם לא היה קריאה למודל. התג הוא בדיקת מילת מפתח, בדיוק כמו שזה נשמע. המסך סורק את הטקסט ומחפש ״high-priority״, ״high priority״ או ״urgent״, מרים את התג אם הוא מוצא, ועושה את זה שוב בכל פעם שהמסך מצויר מחדש.
הנה אחת מארבע ההנחיות האלה, זו של בודק הפלט בבדיקה הכפולה:
You are an impartial reviewer. You are given the GOAL of an automated task and
the OUTPUT it produced. Judge ONLY whether the output fulfills the goal and is
internally consistent (dates, numbers, and claims do not contradict each other).
Respond with ONLY a JSON object of the exact shape {"pass": boolean, "reason":
string, "fix": string} where "reason" is one short sentence and "fix" is a
concrete instruction for what to change (empty string when pass is true). No
prose, no markdown.
הפרומפט הישן של השער אמר למודל לענות continue כשהוא לא יכול לדעת, וכך כיבס כל ריצה לא ודאית לכדי מעבר ירוק ונקי. תיקנו את זה, והערת התיעוד אומרת עכשיו את הכלל שהיא שומרת: ״שער שנשבר אף פעם לא נרשם כהכרעה נקייה.״ אותה הערה נוקבת באתר שעדיין מכבס: ״verify_output בולע תוצאת בודק בלתי קריאה לתוך passed פשוט; זרימות לא רשאיות.״ זה חי, מכוון ומוצמד בבדיקה, כי הכרעה בלתי קריאה לא רשאית להכשיל את הריצה.
חמשת האתרים, אחד אחד
שער על קשת בזרימה. זרימה היא המקום שבו שגרה אחת מפעילה שגרה אחרת כשתנאי מתקיים. אתם משרשרים את השלבים על קנבס, ועל הקו שבין שני שלבים, הקשת, אתם כותבים את התנאי במילים שלכם. הזרימה עוברת בקו הזה רק כשהתנאי מתקיים.
משהו צריך לקרוא את תוצאת השלב הקודם ולהגיד אם התנאי מתקיים. מודל צ׳אט עשה את זה קודם. הוא כתב משפט על התנאי, ומפענח מתחתיו ניסה לחלץ הכרעה מתוך הפרוזה. אותו תנאי הולך עכשיו ל-Jev, שעונה עליו בהסתברות אחת ותו לא, והזרימה עוברת בקשת הזאת רק כשההסתברות היא 0.85 ומעלה. מתחת לזה שום דבר לא נעצר, ההערכה מוסלמת לשער הצ׳אט שרץ קודם, וההגדרה של הקשת עצמה עדיין קובעת מה קורה כשהבדיקה לא מצליחה להכריע.
קחו את הזרימה Linkedin post שלמטה. היא מריצה את AI News Radar, אחר כך את Daily LinkedIn News Post, ואז את LinkedIn Post Publisher, והקשת שיוצאת מהראדאר נושאת תנאי אחד: ״Only run if important news for BinarCode.״
למפתחים: GATE_JEV_CONTINUE_MIN = 0.85. בסף ומעליו הזרימה ממשיכה ולא מוציאה קריאת צ׳אט; מתחתיו ההערכה מוסלמת לשער הצ׳אט. ל-Jev אף פעם אין רשות לעצור זרימה.
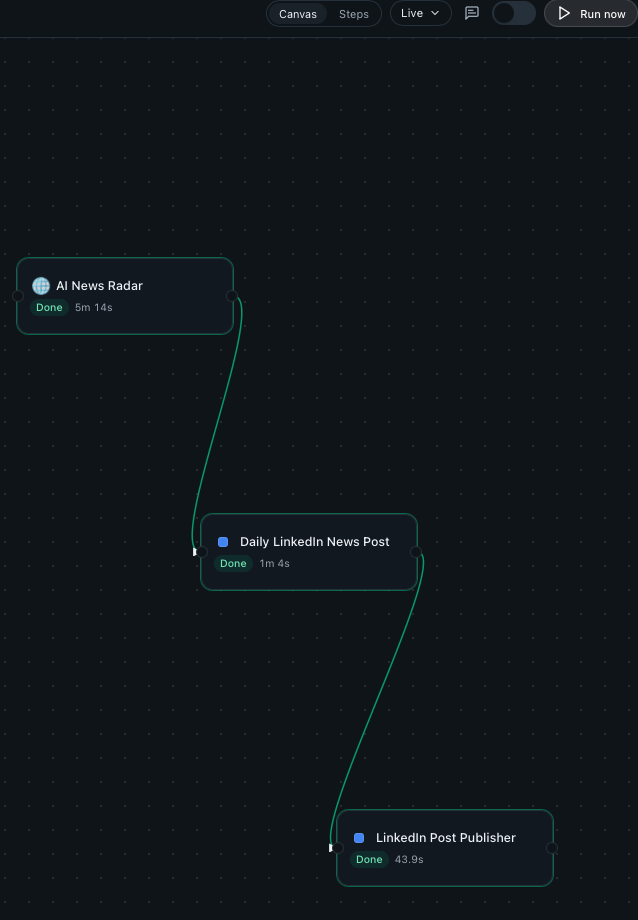 הזרימה Linkedin post. השער יושב על הקשת שיוצאת מ-AI News Radar, וכל שלב בריצה הזאת הסתיים.
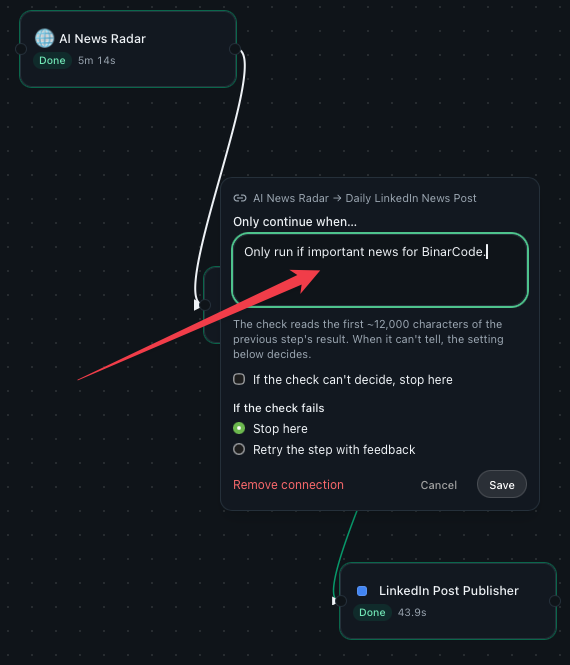 התנאי ש-Jev עונה עליו עכשיו בהסתברות אחת. הבדיקה קוראת את כ-12,000 התווים הראשונים של תוצאת השלב הקודם, וההגדרה שמתחת קובעת מה קורה כשהיא לא יכולה להכריע.
בדיקה כפולה של פלט. שגרה במצב Goal ממשיכה לנסות עד שהתוצאה שלה עומדת בקריטריוני ההצלחה שכתבתם. אתם מקלידים את הקריטריונים האלה כמשפט בעורך השגרות. משהו צריך לבדוק כל תוצאה מול הקריטריונים האלה.
עד גרסה v1.6.0 מודל צ׳אט עשה את הקריאה הזאת: הנחיית בודק החזירה מעבר או כשלון עם נימוק, וקוד מתחתיה חילץ את ההכרעה מהתשובה. עכשיו Jev מנקד קודם את הפלט מול סולם קבוע בן שלוש רמות שכתוב אצלנו בקוד. ציון של 0.85 ומעלה על הסולם הזה, נמדד כחלק מהרמה העליונה, מוסר את הריצה כ-passed ולא מוציא קריאת בודק. כל מה שמתחת לזה עדיין הולך לאותו בודק, כי חוסר חייב לחזור עם משפט תיקון שאפשר לנסות מולו, והכרעה מוטפסת לא יכולה לכתוב משפט.
השגרה שלמטה רצה כל בוקר במצב Goal, והקריטריון שלה הוא: ״the output has exactly 4 sites״.
למפתחים: VERIFY_JEV_PASS_MIN = 0.85 על ערך ה-normalized() של הציון, ובנוסף VERIFY_JEV_CONFIDENCE_MIN = 0.6 כשנמדדת רמת ביטחון. מ-VERIFY_JEV_CONCERN_MAX = 0.5 ועד 0.85 זה מוסלם לבודק הפרוזה. מתחת ל-0.5 זה מוסלם גם כן, ומסמן הסתייגות: זה התחום היחיד שבו הכרעת בודק בלתי קריאה כבר לא נבלעת לתוך מעבר.
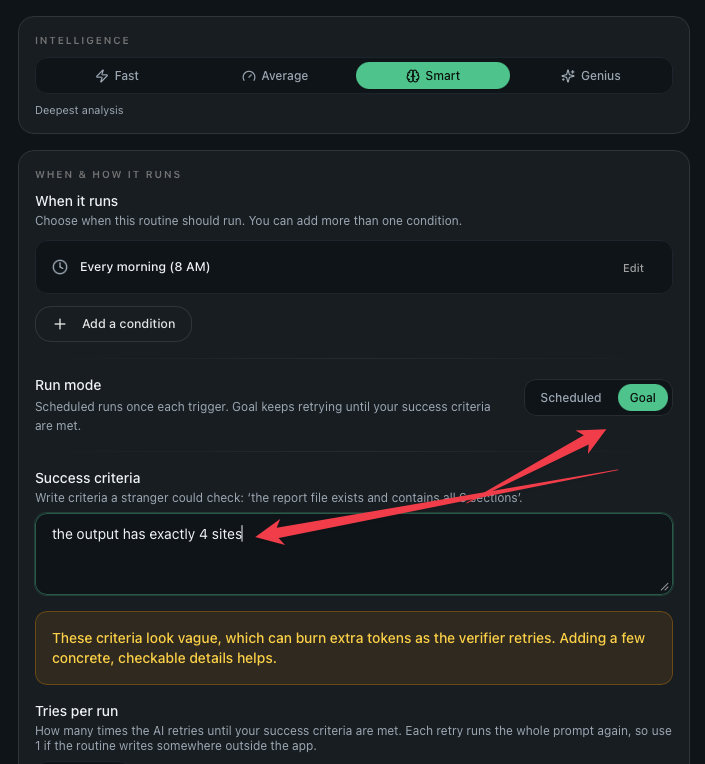 מצב הריצה Goal. קריטריוני ההצלחה נמסרים לבדיקה יחד עם שם השגרה וההנחיה, ו-Jev מנקד את הצירוף הזה לפני שבודק הפרוזה רואה אותו.
בעלות על משימה מפגישה. אחרי פגישה Routines מוציא את פריטי הפעולה ונוקב בבעלים לכל אחד מהם. רק אלה שהם שלכם צריכים להפוך למשימות ברשימה שלכם. התחייבות של מישהו אחר היא לא משימה שלכם.
שאלת הבעלות הזאת חזרה קודם ממודל צ׳אט כמילה, עם קוד מתחתיו שקרא את המילה. עכשיו היא חוזרת כהסתברות: 0.75 ומעלה שומר את הפריט, מתחת ל-0.25 מוחק אותו, וכל מה שבין שני הקווים נופל אל ההכרעה שהמסלול הישן כבר הגיע אליה. קו השמירה יושב מתחת ל-0.85 בכוונה. משימה שגויה מתה במחווה אחת, ומשימה שנמחקה היא התחייבות שאיש לא רואה שוב.
הצילום שלמטה הוא המקום שאליו נוחת פריט ששרד: מסך Tasks, מקובץ לפי מתי הוא נדרש מכם. תחת Today יושב אחד מהם, ״Unblock iPhone push notifications: mint the APNs key into Forge, then plug the iPhone in by USB for the device proof״.
למפתחים: TODO_OWNER_USER_MIN = 0.75 שומר את הפריט, TODO_OWNER_DROP_MAX = 0.25 מוחק אותו, ובין השניים הוא נופל אל ההכרעה המחרוזתית של היום.
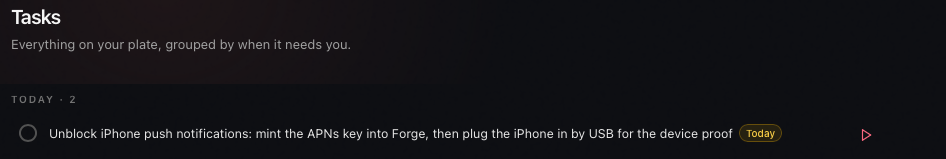 מסך Tasks. פריט פעולה הופך לשורה כאן רק אחרי שמסנן הבעלות שומר אותו.
תג ״דורש תשומת לב״. מסך הבית מראה שורה קטנה בענבר על פלט של שגרה שדורש מכם להסתכל עליו. הוא שם כדי למשוך את העין לתוצאה האחת מכל מה שרץ הבוקר שלא יכולה לחכות.
האתר הזה מעולם לא היה קריאה למודל. המסך סורק את טקסט הפלט ומחפש ״high-priority״, ״high priority״ או ״urgent״, מרים את התג על התאמה, ועושה את זה שוב בכל פעם שהמסך מצויר מחדש. ל-Jev מותר עכשיו להרים את התג כשהוא עונה 0.85 ומעלה, ולא לעשות שום דבר אחר. על ״לא״ בטוח הוא עונה כלום, העמודה נשארת NULL, והשורה נשארת למעלה.
הצילום שלמטה הוא מסך Home במק שהריץ הבוקר את AI News Radar. השורה קוראת ״AI News Radar flagged urgent content״, והתקציר שמאחוריה הוא סיכום חדשות שבמקרה מצטט את המילה urgent. זאת בדיקת מילת המפתח עושה בדיוק מה שהיא תמיד עשתה, כי מחרוזת משנה היא כל מה שיש לה לעבוד איתו. הנמכת השורה הזאת היא הצעד הבא שנקוב בשמו, וגרסה v1.6.0 לא שחררה אותה.
למפתחים: ATTENTION_FLAG_MIN = 0.85 מרים את התג. כל השאר עונה כלום, העמודה נשארת NULL, ובדיקת מילת המפתח רצה כמו קודם.
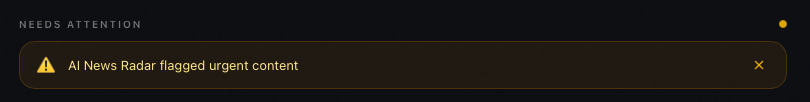 התג במסך הבית. סיכום חדשות שרק מצטט את המילה urgent עדיין אוסף אותו.
איור 1. השער לפני ואחרי. רק ״כן״ בטוח מדלג על קריאת הצ׳אט.
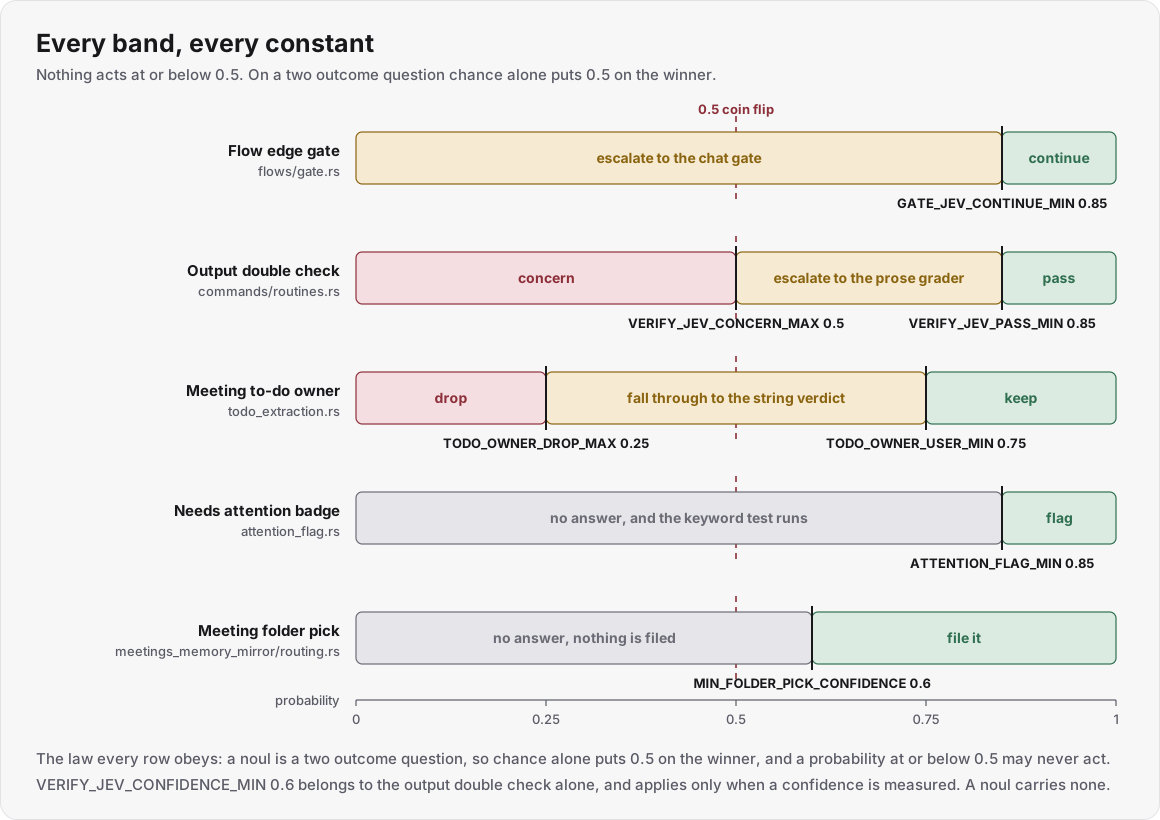 איור 2. כל תחום, כל קבוע. שום דבר לא פועל ב-0.5 או מתחתיו, כי בשאלה דו ערכית המקרה לבדו שם 0.5 על המנצח.
בחירת תיקייה לפגישה. כשפגישה נגמרת, Routines מתייק את הסיכום לאחת מתיקיות ההערות שלכם. הוא צריך לבחור לאיזו. בחירה טובה מניחה את הסיכום ליד הפרויקט שהוא שייך לו.
מודל צ׳אט בחר קודם, וקוד מתחתיו קרא שם תיקייה מהתשובה שלו. כשיש מפתח שמור ולפחות שתי תיקיות שאפשר לתייק אליהן, Jev עונה ובקשת הצ׳אט כבר לא נבנית, כך שהקריאה היקרה פשוט לא קורית. בחירה שעוברת את הקו מתייקת את הסיכום לתיקייה שהיא נוקבת בשמה, וכל מה שמתחת משאיר אותו במיקום ברירת המחדל. להגיד ״לא״ זול כאן, ובגלל זה הקו הוא 0.6 ולא 0.85: בחירה שנדחתה משאירה את הסיכום בדיוק במקום שבו הוא כבר נמצא, ואילו בחירה שגויה ובטוחה קוברת אותו בתוך תיקיית פרויקט של מישהו אחר.
למטה זה התחום הזה מבחוץ. Routines הקליט, סיכם ותייק פגישת Hackathon ב-18 בספטמבר, והשורה התחתונה מתחת לסיכום נוקבת בשם הקובץ שאליו היא הלכה: meetings/2026-09-18/1115-meet-hackathon-binar.md. זה מיקום ברירת המחדל, וזה שכל מק בלי מפתח מקבל לכל פגישה.
למפתחים: MIN_FOLDER_PICK_CONFIDENCE = 0.6; מתחתיו הסיכום הולך למיקום ברירת המחדל. הוא שוחרר בגרסה v1.5.15, וארבעת התחומים שמעליו הם מה שגרסה v1.6.0 הוסיפה.
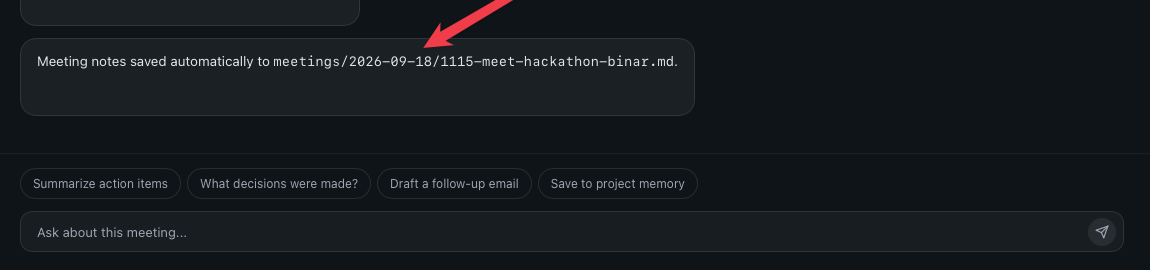 קובץ ברירת המחדל. לכאן נוחתים סיכומי פגישה כשבחירת התיקייה לא עוברת את 0.6, ולכאן הם נוחתים בכל מק בלי מפתח בכלל.
כל החמישה בנויים באותה צורה. לכל אחד יש קבוע בעל שם שאפשר לקרוא בקוד, מסלול לתשובה ש-Jev לא בטוח בה, ואותה הבטחה של ״בלי מפתח״: כשאין מפתח החלטה שמור, המסלול המוטפס לא קיים והענף הישן רץ.
המספרים החיים
ההוכחה החיה היא ארבע בדיקות probe מסומנות ignore, אחת לכל אתר. ה-probe של התג רץ בלולאה על שני מקרים, ולכן ארבע בדיקות מייצרות חמש קריאות: $0.000016, $0.000019, $0.000028, $0.000020 ו-$0.000019, בסך הכול $0.000102. הדוח שלנו עצמו אמר $0.000083, שהוא ארבע הראשונות מבין החמש: הוא ספר בדיקות, לא קריאות.
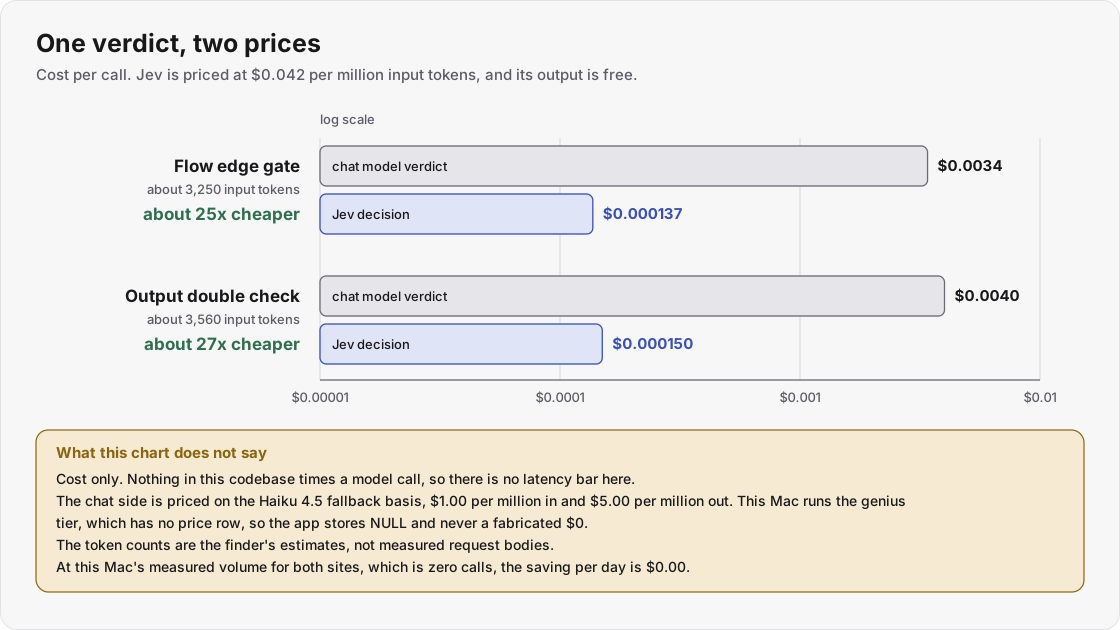 איור 3. עלות לקריאה, נגזרת מחדש מספירות הטוקנים לפי $0.042 למיליון טוקני קלט. ההשהיה לא מצוירת: שום דבר בקוד הזה לא מודד זמן של קריאה למודל.
ב-$0.042 למיליון טוקני קלט כשהפלט חינם, 3,250 הטוקנים המוערכים של השער עולים $0.000137 מול $0.0034 להכרעת הצ׳אט, זול פי 25; 3,560 הטוקנים של הבודק עולים $0.000150 מול $0.0040, פי 27. ספירות הטוקנים האלה הן הערכות של המאתר, לא גופי בקשה שנמדדו, וצד הצ׳אט מתומחר על בסיס הנפילה לאחור של Haiku 4.5: ה-Mac הזה רץ בשכבה שאין לה שורת מחיר, ולכן האפליקציה שומרת NULL ואף פעם לא אפס מומצא. בנפח המדוד של ה-Mac הזה לשני האתרים, אפס, החיסכון ליום הוא בדיוק $0.00. ההשהיה המפורסמת של Jev היא 70 עד 500 מילישניות, המספר של הספק ולא שלנו.
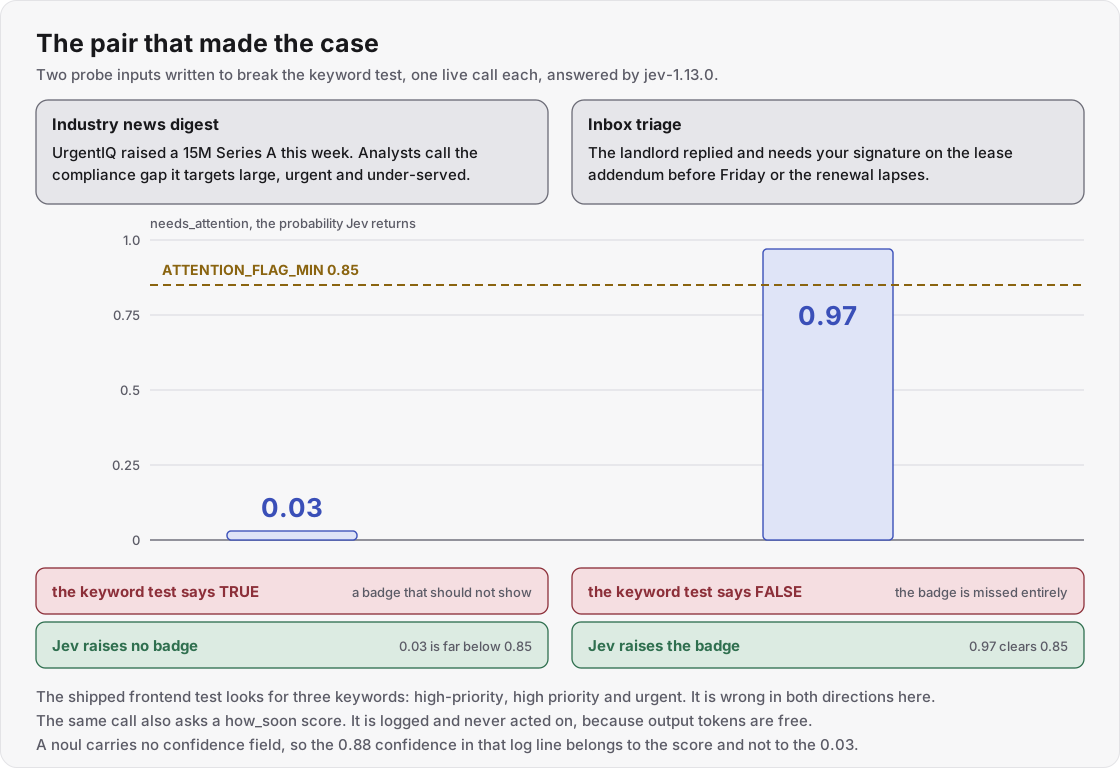 איור 4. הזוג שעשה את הטיעון. בדיקת מילת המפתח ששוחררה טועה בשני הכיוונים; Jev צודק בשניהם.
הזוג שעשה את הטיעון של התג רץ מול jev-1.13.0. הפיתיון: ״UrgentIQ raised a 15M Series A this week. Analysts call the compliance gap it targets large, urgent and under-served.״ בדיקת מילת המפתח מתייגת אותו. Jev מחזיר needs_attention 0.03 ולא מרים כלום, כי הקריטריון false של השאלה עצמה מכסה אותו: פלט ש״נוקב בשם של חברה או מוצר שהשם שלו מכיל מילה כזאת״ הוא לא פלט שדורש אתכם. השני: ״The landlord replied and needs your signature on the lease addendum before Friday or the renewal lapses.״ בדיקת מילת המפתח אומרת FALSE; Jev מחזיר 0.97.
איור 5. שני הפלטים דרך שני המסלולים, בדיקת המחרוזת והשופט.
טעינו בדיוק אחד בסקירה ותפסנו אותו לפני שהפך לכרטיס. אותה קריאה שואלת גם ציון how_soon, ועל הפיתיון הוא חזר ב-0.08 עם 92 אחוז מהמסה שלו על ״אין צורך בפעולה״ ועם ביטחון 0.88. ה-0.88 שייך לציון, לעולם לא ל-0.03. ל-noul, צורת הכן או לא, אין שדה ביטחון. הציון נרשם ביומן ואף פעם לא פועלים לפיו: טוקני פלט הם חינם, וכיול מחדש עתידי של ATTENTION_FLAG_MIN ירצה את ההתפלגות של ה-Mac הזה עצמו.
מה זה מודל החלטה מסוג System One
Jev הוא מודל ה-System One של TypeSafe AI, ופוסט ההשקה הוא שלהם להסביר. חוזה החוט הוא בקשת POST אל https://api.typesafe.ai/v1/systemone תחת מפתח Bearer, שנושאת state, model ומפה של questions שהמפתחות שלה שלכם. noul עונה כן או לא בהסתברות אחת בין 0 ל-1. choice בוחרת אחת ממפה של אפשרויות בשם, עם הסתברות לכל אחת ורמת ביטחון. score ממקם את המצב על סרגל מסודר של שתי רמות לפחות ומחזיר ציון, התפלגות, מקרא ורמת ביטחון.
הנה זה ב-Postman, קטן ככל שקריאת הכרעה יכולה להיות. ה-state הוא מה ש-Jev מסתכל עליו, כאן משפט אחד. ה-model נוקב במי לשאול. מפת ה-questions מחזיקה את מה שרוצים להכריע, והמפתח sky_is_blue הוא שם שאנחנו בחרנו, כך שהתשובה חוזרת מתויקת תחתיו. זאת כל הבקשה. שום דבר בה לא אומר למודל איך לנסח תשובה, כי הוא לא יכול לנסח כלום.
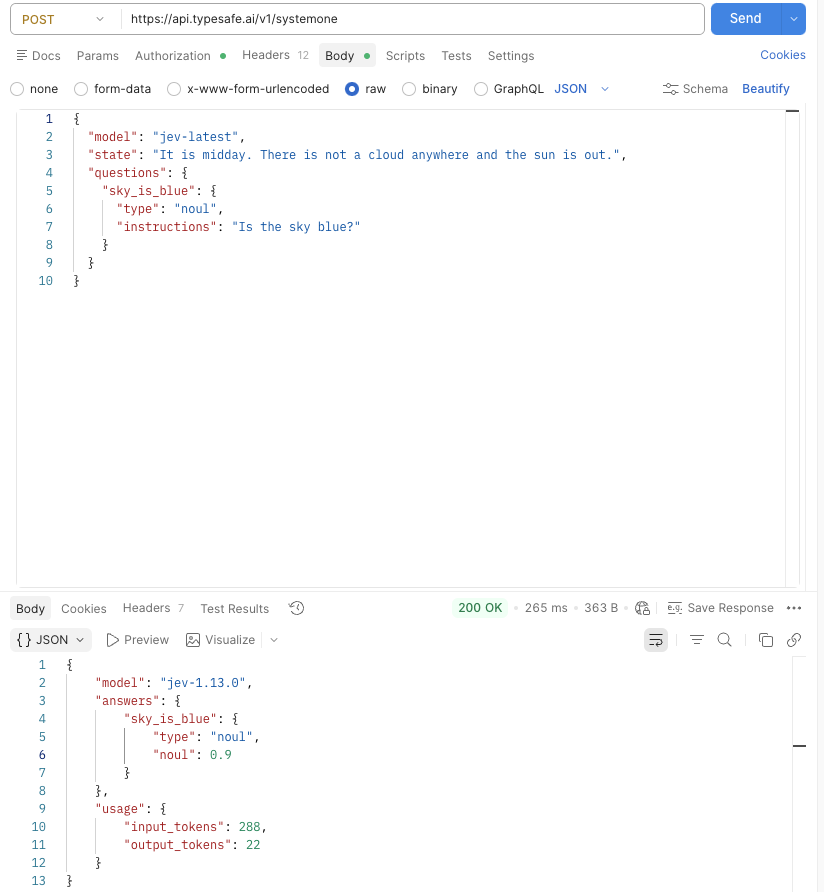 איור 6. קריאת ההכרעה הקטנה ביותר שיש. התשובה היא מספר, והמספר הוא כל התשובה.
חזר "noul": 0.9. זאת כל התשובה: השמיים כחולים בהסתברות של 90 אחוז, בלי משפט מסביב שצריך לעבור עליו ובלי שדה ביטחון לצידו, כי בשאלת כן או לא ההסתברות היא אי הוודאות. הקריאה חויבה על 288 טוקני קלט, כ-$0.000012 לפי $0.042 למיליון, ו-22 טוקני הפלט לא עלו כלום כי TypeSafe גובה רק על קלט. Postman מדד את זמן הלוך ושוב ב-265 ms, וזאת קריאה אחת ממחשב אחד דרך האינטרנט הפתוח ולא מדידה של שום דבר.
הבקשות האמיתיות נראות אותו דבר, רק ארוכות יותר. החצי של needs_attention מתוך הבקשה של התג, עם שתי מחרוזות הקריטריונים מקוצרות והמצב מוחלף בממלא מקום. ציון how_soon רוכב על אותה קריאה.
{
  "state": {
    "routine_name": "<the routine's name>",
    "output_excerpt": "<the first 800 characters of the output>"
  },
  "model": "jev-latest",
  "questions": {
    "needs_attention": {
      "type": "noul",
      "instructions": "Does this output tell the user about something of their own that needs action soon?",
      "criteria": {
        "true": "[...]",
        "false": "[...] names a company or product whose name contains such a word"
      }
    }
  }
}
זה מה שחזר על פיתיון שכתבנו כדי לשבור את בדיקת מילת המפתח, עם usage ו-legend מקוצרים.
{
  "model": "jev-1.13.0",
  "answers": {
    "needs_attention": { "type": "noul", "noul": 0.03 },
    "how_soon": {
      "type": "score",
      "score": 0.08,
      "probabilities": { "0": 0.92, "1": 0.08, "2": 0.0 },
      "confidence": 0.88
    }
  }
}
לתשובת noul אין שדה ביטחון. השדות היחידים שלה הם הסוג וההסתברות, וההסתברות היא אי הוודאות. Jev לא יודע לכתוב טקסט בכלל, ולכן הוא מחליף את הפרסור ומשאיר את הפרוזה למודל הצ׳אט. ה-AI SDK של Laravel שילח את אותה צורה ב-2026-09-17 ב-PR laravel/ai#1010, בשמות Boolean, Choice ו-Score, מזהה ספק typesafe, מודל ברירת מחדל jev-latest. שיקפנו את השמות שלו.
הארכיטקטורה: ה-LLM כותב, Jev מכריע, הקוד שולט
ה-LLM עדיין כותב. Jev מחזיר מספר. הקוד מחזיק את הסף, קבוע בעל שם שאתם יכולים לקרוא. כשהמספר לא מספיק, התשובה מנותבת למקום שכבר היה שם: מסלול הצ׳אט, או בן אדם.
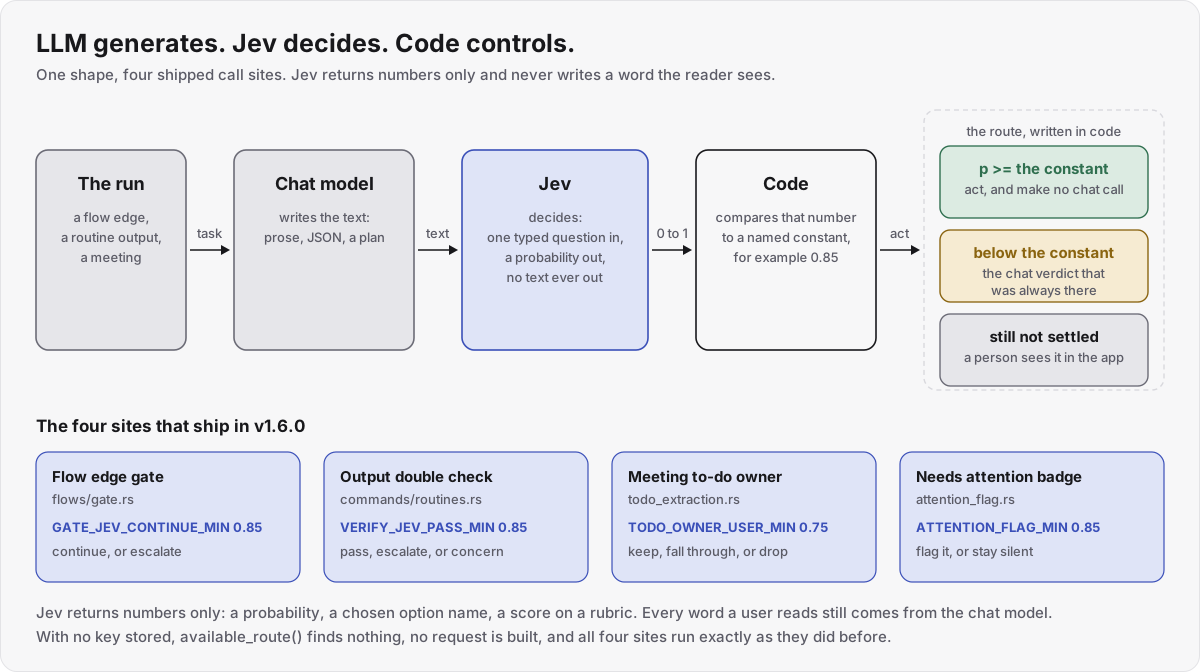 איור 7. ה-LLM כותב, Jev מכריע, הקוד שולט, והתחום הלא ודאי מנותב למסלול שתמיד היה שם.
איור 8. הכרעה אחת, מקצה לקצה. בלי מפתח שמור, הריצה הולכת במסלול שתמיד הלכה בו.
בדיקות מצמידות את ההבטחה של ״בלי מפתח״. הכלי decide נרשם רק כשהאפליקציה מוצאת מפתח החלטה, וארבעת האתרים מגיעים ל-Jev דרך אותה בדיקת מפתח עצמה, כך שההצמדה של התג טוענת ששום דבר לא נשלח והעצירה קורית לפני שנבנית בקשה. ההצמדה הזאת מקבעת את ההתנהגות שביקרנו למעלה.
#[tokio::test]
async fn with_no_key_an_unreadable_verdict_is_still_absorbed_into_passed() {
    // THE pin. Today an unreadable grader verdict delivers the run marked
    // "passed" with no note, and with no decision key that must not change
    // by a single byte.
    let (result, sends) = run_double_check(
        JevVerdict::Unjudged,
        &verify_long_output(),
        vec![Ok("totally not json".to_string())],
    )
    .await;
    let result = result.expect("a verdict was returned");
    assert_eq!(result.status, "passed");
    assert_eq!(result.content, verify_long_output());
    assert_eq!(result.note, None);
    assert_eq!(sends, 1);
}
איך בחרנו איפה לשים אותו
ארבעה מאתרים עיוורים סרקו את הקוד לפי דפוס, לפי תת מערכת, לפי נתונים ולפי עלות. מיזגנו את המועמדים שלהם ומדדנו נפח מול מסד ה-SQLite של האפליקציה עצמה. הנוסחה היא רווח צפוי כפול נפח מדוד, חלקי סיכון, שניהם בסולם 1 עד 5, כשסיכון הוא כמה רע וכמה בשקט נוחתת תשובה שגויה, כפול כמה משטח השינוי נוגע בו.
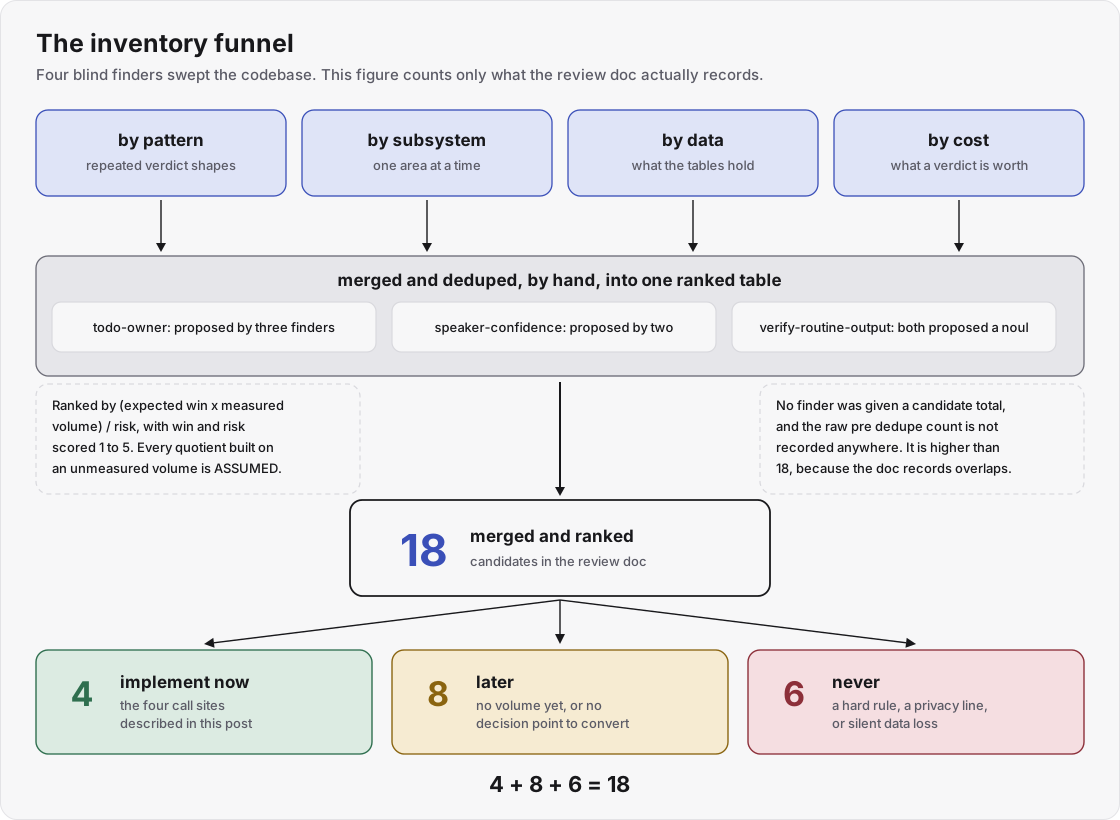 איור 9. משפך המלאי. הספירות של כל מאתר מעולם לא נרשמו, ולכן האיור נוקב בשמן של ארבע הזוויות וסופר רק את מה שמסמך הסקירה באמת מחזיק.
גם הספירה הגולמית לפני האיחוד לא נרשמה, ולכן לא שמנו עליה מספר. מה ששרד: 18 מועמדים מדורגים, 4 ליישום עכשיו, 8 לאחר כך, 6 לעולם לא.
שני המועמדים שהתדריך עצמו זרע, השער והבדיקה הכפולה, מדדו שניהם נפח אפס נוכחי: אפס מתוך 6 קשתות זרימה נושאות תנאי, אפס מתוך 687 פלטים נושאים סטטוס אימות. הם שוחררו כדירוג 1 ו-2 בכל זאת, כל אחד על הנחה קדימה משלו שנאמרה במפורש. של השער: ריצות הזרימה רצו 2 ביום מ-2026-08-08 עד 2026-09-03 ואז נעצרו, כך ש-2 ריצות ביום על 1 קשת מגודרת הן 2 הערכות ביום. מעוגן בהיסטוריה, אבל הנחה, והסקירה מתייגת אותה ככזו.
בנפח מדוד הסדר שונה: 6.9 לתג, 3.4 לבעלות על המשימה, 5.0 לשער על הנפח המונח שלו, ו-0.78 או 17.0 לבודק, גם שני אלה על נפח מונח. הנפח המדוד הגבוה ביותר מבין הארבעה, 10.27 פלטי רוטינה גמורים ביום, שייך לתג, שלא התדריך ולא חצי מהמאתרים הובילו איתו, כי הוא היה בדיקת מחרוזת ולא קריאה למודל.
החוקים שהפקדנו
- שום דבר לא פועל ב-0.5 או מתחתיו בשאלה דו ערכית: המקרה לבדו שם 0.5 על המנצח.
- אפשרות ״לא בטוח״ הופכת את הכיול: היא עושה מאי הוודאות תשובה ולוקחת מסה מהתוצאות האמיתיות, ועם שלוש אפשרויות המקרה יושב על 0.33.
- האפשרויות מגיעות מהקוד, אף פעם לא מהמצב. השם של האפשרות המנצחת ב-choice נרשם ביומן, וזה מה שהופך את הכלל הזה לנושא משקל.
- אף פעם אל תגדרו סוכן עם כלים מאחורי מסווג.
- ל-
noulאין שדה ביטחון. ההסתברות היא אי הוודאות. - רשמו ביומן את ההחלטה, אף פעם לא את המצב.
- לכל תשובה לא ודאית צריך מסלול כתוב, ושגיאת תעבורה לוקחת את אותו מסלול.
- שמרו חשבון וכללים קשיחים בקוד. Jev שופט משמעות.
מה לא עשינו, ומה הלאה
שישה מועמדים סומנו ״לעולם לא״. נתב הכוונה של צ׳אט הפגישות נשאר נתב: חוק 4 מצוטט מזיכרון הפרויקט שלנו עצמו, וכישלון פתוח עושה אותו לשער שנכשל בכיוון הבטוח, לא לשער שהפסיק להיות שער. רשימת ההיתרים של הגישה ל-Slack נשארת כלל קשיח, כי בקרת גישה הסתברותית היא פגם מעצם הבנייה. מיזוג אוטומטי של התנגשות בסנכרון נשאר ידני: מיזוג שגוי הוא אובדן שקט ובלתי הפיך בתוך ה-vault של המשתמש עצמו, וספירת ההתנגשויות היא אפס, ולכן אין גם נתוני כיול. מסווגים ללוח הגזירים בחוץ, כי לוחות גזירים נושאים סיסמאות וטוקנים. משווי הכללים הקשיחים משווים מחרוזות מדויקות שנוצרות פנימית, וכמה מהם רצים בלולאות חמות שבהן קריאת רשת פוסלת. הפרוקסי של הארנק המנוהל מחוץ לתחום לפי הכלל של התדריך עצמו.
שלושה דברים הלאה. השלילה הבטוחה: השופט של התג אף פעם לא מחזיר ״לא״ בטוח היום, ולכן ״לא״ כזה נופל אל בדיקת מילת המפתח והתג השגוי מוצג. הפיתיון ייצר את נקודת הכיול שחסרה, והעמודה והרכיב כבר יודעים לטפל ב-false. השארנו את זה מחוץ למעבר הזה, כי שינוי סמנטיקה של החלטה אחרי אישור יריב בלי אימות חוזר הוא בדיוק האופן שבו משוחררת התנהגות לא מאומתת. ספים מכוילים על הנתונים שלנו: כל קבוע למעלה הוא שיקול דעת, ועמודת דירוג המשתמש היא NULL בכל שורת פלט, ולכן אין עדיין קורפוס מתויג. גרסת מודל מוצמדת: jev-latest עוקב אחרי היציב ורץ היום; אחרי הכיול ההצמדה עוברת ל-jev-1.13.0, כדי שעדכון של הספק לא יזיז סף מתחתינו.
הפועל routines decide והכלי decide שוחררו בגרסה v1.5.15, ומדריך ה-CLI מתעד את הפועל, כולל מפתח ה-TypeSafe או ה-OpenRouter שהוא דורש. ארבעה מחמשת האתרים שלמעלה חיים בגרסה v1.6.0. כרטיס מפתח ה-TypeSafe יושב בהגדרות, תחת חיבורים. מפתח OpenRouter יושב בהגדרות של ספק הבינה, במקום שבו הוא כבר נמצא אם אתם משתמשים באחד לצ׳אט. כך או כך המפתח חי ב-Keychain של macOS ואף פעם לא מסתנכרן בין מחשבי Mac. בלעדיו שום דבר באפליקציה לא משתנה. איתו, הטקסט ש-Jev שופט נשלח אל אותו ספק, ויומן ההחלטות שומר את ההכרעה ולא את המילים: אף פעם לא את טקסט המצב, בלי ציטוט ממנו, בלי שום דבר שנגזר ממנו, עם בדיקה שנכשלת אם כן.
Routines היא הורדה חינמית ל-macOS, עם CLI ועם מדריך הפקודות שלו. אחת מההכרעות שלמעלה נראית מבחוץ: תג ״דורש תשומת לב״, בכל רוטינה שתבנו ממתכון מיון תיבת הדואר.