כמעט כל מדריך על איך לבנות מוח שני עם AI מתחיל אתכם מאפס. להתקין את האפליקציה, ליצור vault, לתכנן את מבנה התיקיות, ואז להתחיל לתעד. בעוד שישה שבועות, אם תתמידו, יהיה לכם משהו ששווה לחפש בו.
היום הראשון שלכם הוא לא אפס. יש תיקיית Downloads עם שנתיים של קובצי PDF. יש שולחן עבודה מכוסה בצילומי מסך שצילמתם כי משהו היה חשוב במשך ארבע דקות. יש ייצוא ישן מ-Notion שלא פתחתם שוב. הערות פגישות בשלוש אפליקציות שונות. חוזים, מצגות, חשבוניות, ותיקיית מחקר מפרויקט שסגרתם באביב שעבר.
הערימה הזאת היא לא מה שעומד בינכם לבין מוח שני. היא המוח השני, בצורתו הגולמית. החלק היחיד שחסר הוא השלב שבו כל קובץ נקרא, מסוכם, מתויג, מחובר לשאר ומונח במקום שאפשר למצוא. זה השלב שמודל AI כבר יודע לעשות בכמויות, וזאת הסיבה היחידה שבכלל שווה לגשת לערימה. המאמר הזה עוסק בדיוק בשלב הזה, בקנה המידה שבאמת יש לכם, במקום להעמיד פנים שהידע שלכם מתחיל היום.
מה באמת משתנה כשבונים מוח שני עם AI
השיטה הקלאסית, Building a Second Brain של Tiago Forte, בנויה מארבעה שלבים: תיעוד, ארגון, זיקוק וביטוי. המסגרת הזאת החזיקה מעמד יפה. הוויכוחים עליה נוגעים בעיקר לשני השלבים האמצעיים.
ארגון וזיקוק הם השלבים היקרים, והם הסיבה שרוב ה-vaults נראים מצוין במשך חודש ואז נרקבים. התיעוד כמעט חינם, ולכן אתם עושים ממנו הרבה, וכל תיעוד מוסיף בשקט חוב: משהו שצריך לקרוא ברצינות, לסכם, לתייג ולתייק. החוב מצטבר מהר יותר ממה שמישהו מחזיר. חצי שנה אחר כך יש לכם 900 פריטים ואתם לא סומכים על אף אחד מהם, וזה בדיוק כמו לא להחזיק כלום.
מוח שני מבוסס AI לא משנה את התיעוד, והוא לא משנה מה תעשו עם הידע אחר כך. הוא משנה את האמצע. לקרוא מסמך ולהפיק ממנו כותרת, סיכום, נקודות מפתח, תגיות ומיקום הגיוני זו בדיוק העבודה שמודל שפה טוב בה, ובדיוק העבודה שאנשים עסוקים מדלגים עליה. זה כל ההימור. שפטו כל כלי בקטגוריה הזאת לפי השאלה אם הוא מוריד את חוב התחזוקה, ולא לפי כמה תצוגת הגרף שלו יפה.
מה באמת שייך למוח שני
לפני שאתם מוסיפים משהו, כדאי להיות ברורים לגבי מה אתם בונים, כי ״כל מה שיש לי״ הוא יעד גרוע.
שלושה מבחנים, לפי הסדר:
- תרצו את זה בחזרה, במילים, בהמשך? החלטות והנימוקים שמאחוריהן, מספרים שציטטתם פעם אחת, אפיון, התנאים האמיתיים של חוזה, מחקר ששילמתם עליו בזמן שלכם. אלה הליבה. קשה לשחזר אותם וקל לשמור אותם.
- כבר קיים מקור אמת טוב יותר? תוכנת הנהלת החשבונות שלכם מכירה את החשבוניות שלכם טוב יותר מכל הערה. הריפוזיטורי הוא האמת לגבי הקוד שלכם. אל תכפילו מערכת שכבר מוסמכת, תתעדו את הסיכום או את ההחלטה, לא את כל הפנקס.
- הייתם קוראים את זה שוב? קובצי התקנה, תמונות רקע, ארבעים גרסאות של אותה מצגת ותמונות של הצהריים שלכם הם לא ידע. מוח שני הוא לא גיבוי, ולהתייחס אליו ככה נותן vault שלם מבחינה טכנית וחסר תועלת בפועל.
מוח שני טוב קטן מהדיסק שלכם וגדול מאפליקציית ההערות שלכם. באמצע הזה הוא עובד.
הגדירו את התיקיות לפני שאתם מוסיפים
זה השלב שאנשים מדלגים עליו, וזה השלב שקובע אם התוצאה ניתנת לחיפוש או שהיא מזבלה.
כמה כללים שמחזיקים מים:
- פחות תיקיות ראשיות ממה שנדמה לכם. שמונה עד שתים עשרה. אם אתם לא מסוגלים להחזיק את הרשימה בראש, לעולם לא תתייקו לתוכה בביטחון, וגם לא שום דבר שמתייק בשמכם.
- קראו לתיקיות על שם דברים שנשארים, לא על שם פרויקטים שנגמרים.
05_salesיאריך ימים יותר מ-״דחיפת הפייפליין ברבעון השלישי״. תחומי עבודה יציבים, פרויקטים זמניים ושייכים בתוכם. - מספרו את הקידומות.
01_personal,02_company,03_team,04_projectsמסתדרים בסדר שבו אתם חושבים, ולא לפי אלפבית במקרה. - שמרו על רמה ראשונה רדודה ותנו לעומק לקרות מתחתיה. רמה ראשונה שטוחה וברורה היא מה שגורם לתיוק אוטומטי לנחות במקום הנכון, כי הבחירה היא בין שתים עשרה אפשרויות ברורות ולא בין מאה מקוננות.
הנקודה האחרונה חשובה יותר משהיא נראית. כש-Routines מתייקת מסמך שהוספתם, המודל יכול לבחור רק תיקייה שכבר קיימת ב-vault שלכם, או להציע שם ראשי חדש אחד. כל דבר אחר נופל חזרה לתיקיית ברירת המחדל. המבנה שלכם הוא מדיניות התיוק. השקיעו בו עשרים דקות לפני שאתם מוסיפים ארבע מאות קבצים, לא אחרי.
הגרסה הכנה: לעשות את זה ביד
אתם יכולים לעשות את כל זה בעצמכם, היום, בחינם. לפתוח PDF בחלון ליד Obsidian, לקרוא אותו, לכתוב סיכום בחמש שורות, להוסיף שלוש תגיות, לקשר אותו לשתי ההערות שהוא קשור אליהן ולגרור אותו לתיקייה. שום דבר כאן לא דורש AI, ועבודה ידנית מייצרת הערה טובה יותר מכל מודל, כי אתם יודעים איזה פרט היה חשוב.
ואז תעשו את החשבון. קובץ PDF בן עשרים עמודים שנקרא כמו שצריך ומסוכם בכנות לוקח חמש עד עשר דקות. ארבע מאות קבצים הם 30 עד 60 שעות. זה שבוע וחצי עבודה מלא, על משימה בלי דדליין, שמתחרה בעבודה האמיתית שלכם. כמעט אף אחד לא מסיים. רוב האנשים עושים ארבעים קבצים, מרגישים טוב, ונעצרים.
אז הבחירה האמיתית היא לא ״סיכומי AI מול הסיכומים שלי״. היא ״סיכומי AI של ארבע מאות קבצים מול הסיכומים שלי של ארבעים ושום דבר לכל השאר״. אם הארכיון שלכם באמת קטן, או שהחומר כל כך מקצועי שרק הקריאה שלכם שווה משהו, עשו את זה ביד ודלגו על שאר המאמר. Obsidian מצוינת והיא לא הולכת לשום מקום. אם הארכיון שלכם בגודל שבו ארכיונים של אנשים באמת נמצאים, הפכו את שלב הקריאה והתיוק לאוטומטי ותשקיעו את תשומת הלב בחלקים שצריכים אתכם.
מוסרים לה את הקבצים ומסתכלים מה קורה
Routines היא אפליקציית Mac מקומית מיסודה שאנחנו בונים, וזה החלק שהיא הופכת לאוטומטי. ה-vault, שבממשק העברי של האפליקציה נקרא ״הזיכרון״, הוא תיקייה רגילה של קובצי markdown. קבצים נכנסים, הערות יוצאות.
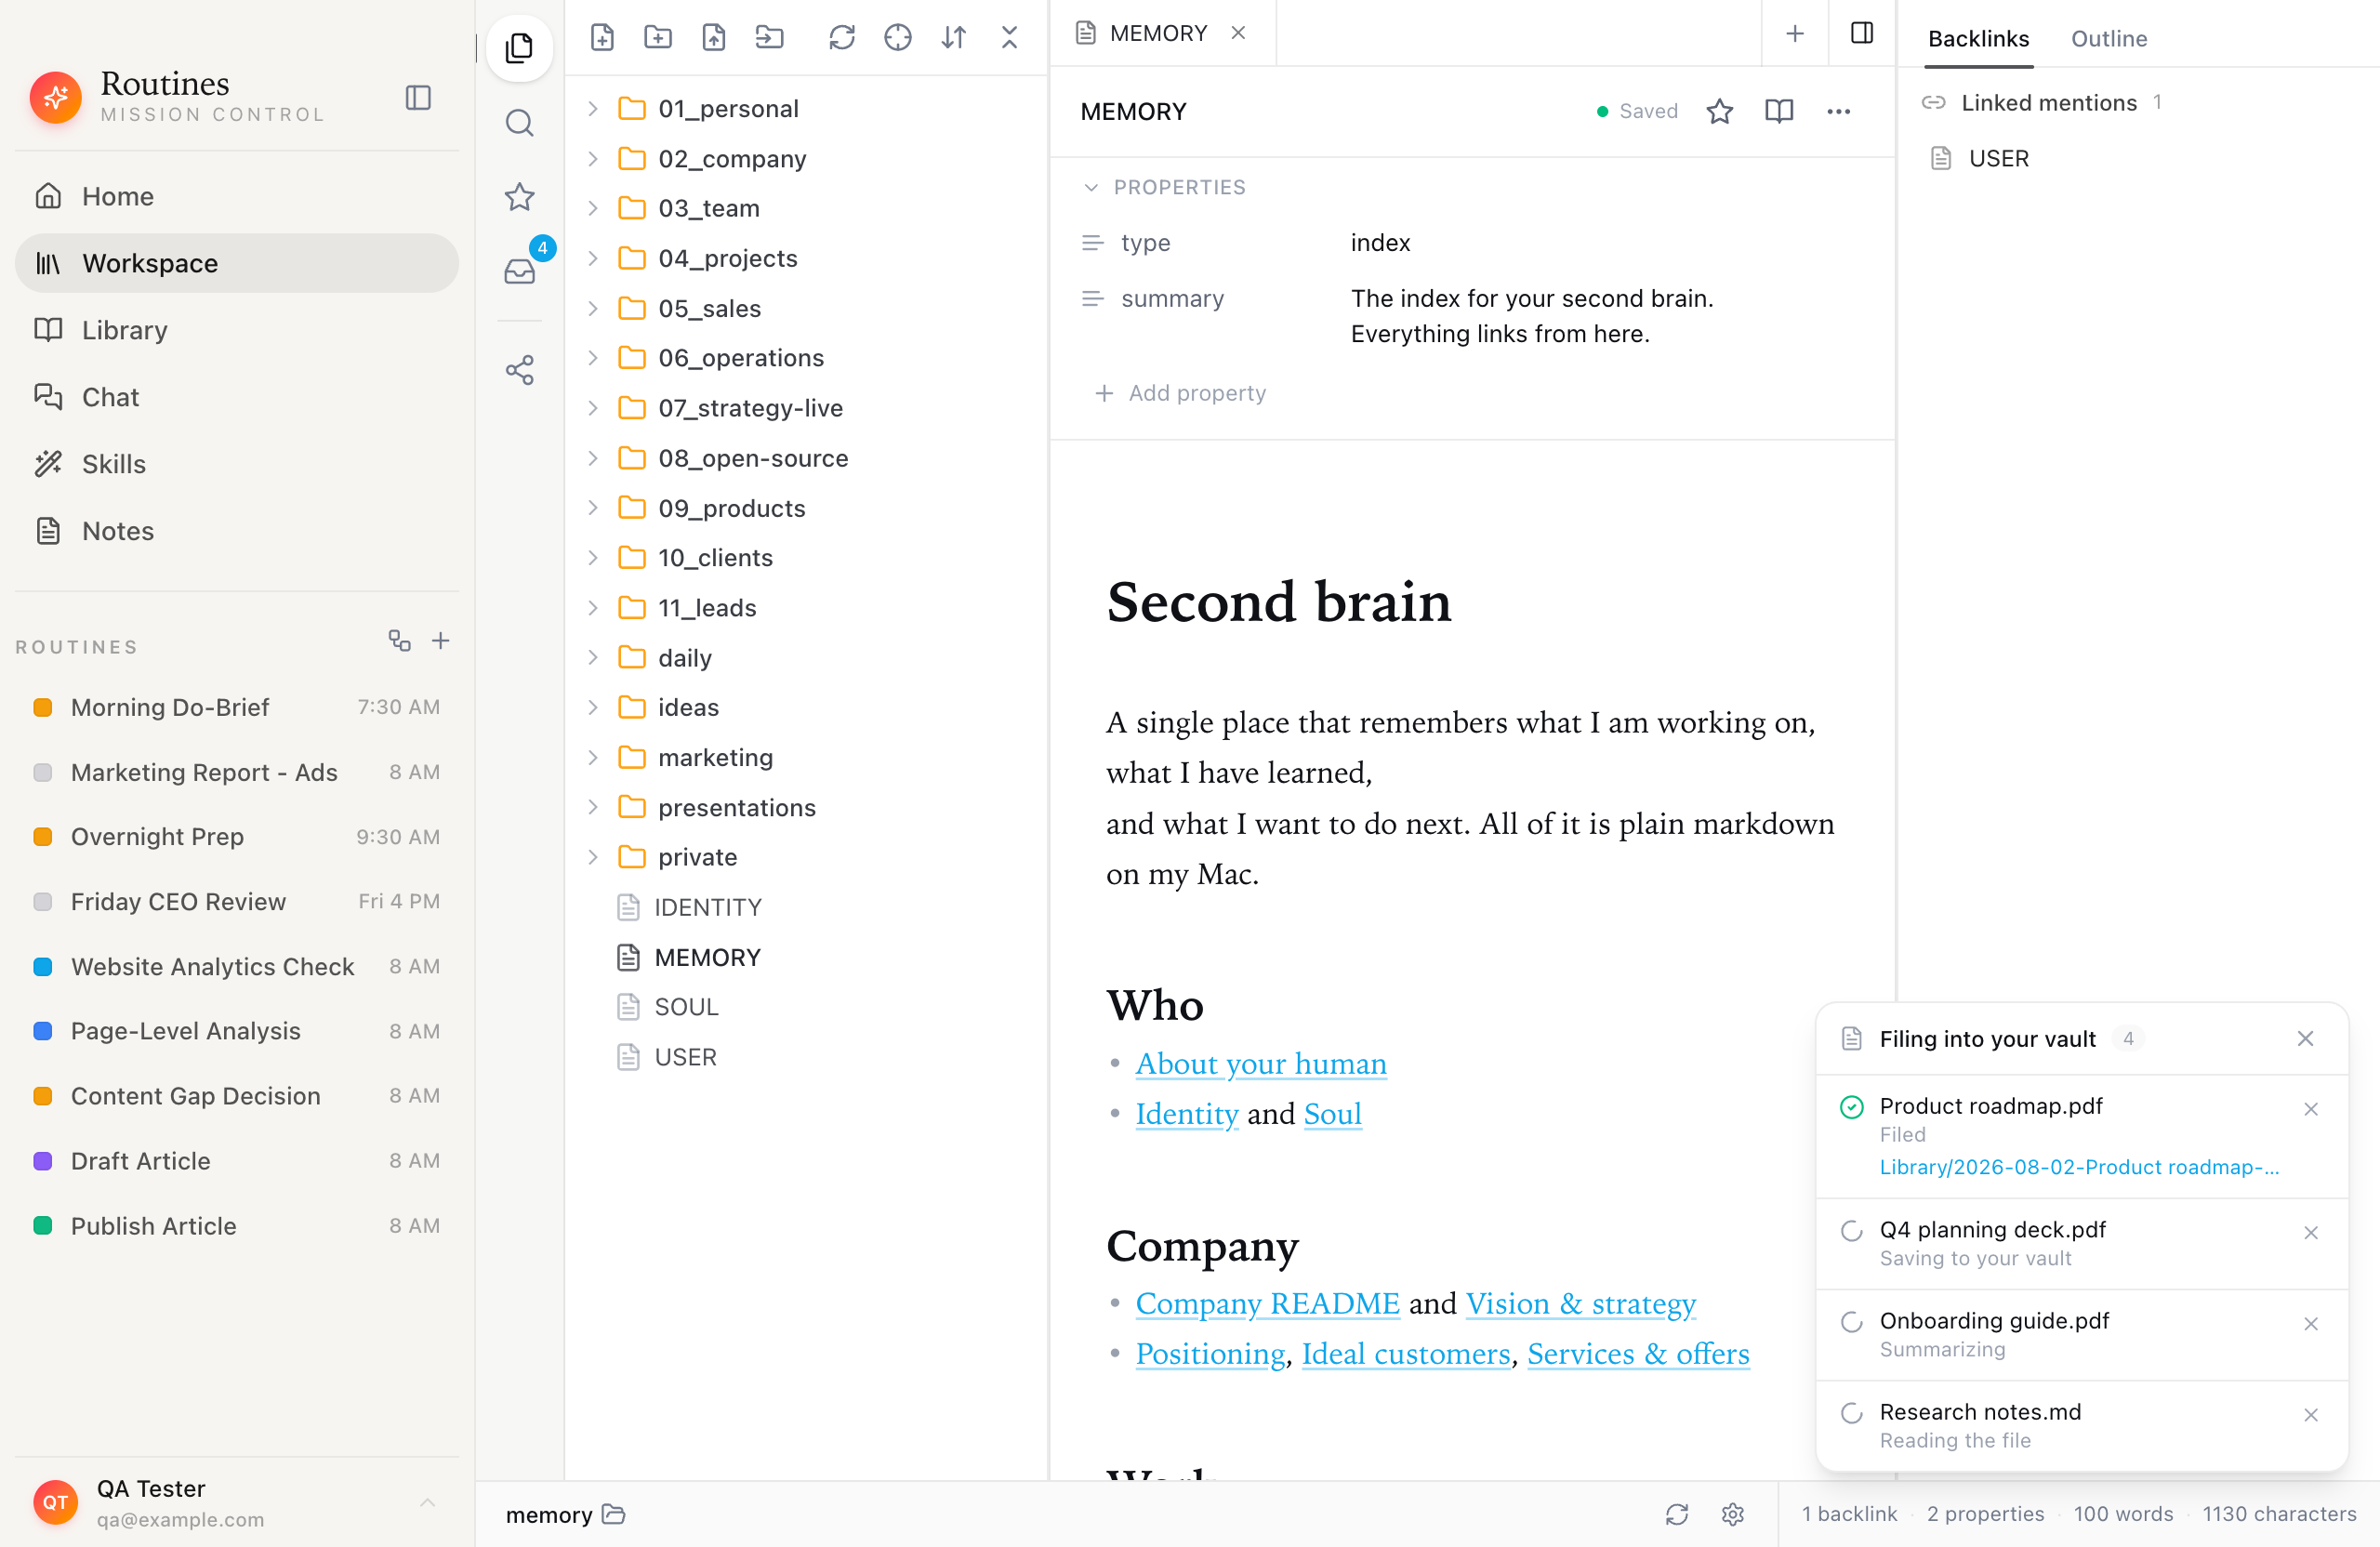
ארבעה קבצים שנגררו בבת אחת. כל שורה מראה איפה הקובץ נמצא במסלול, ושורה שכבר תויקה מקשרת להערת ה-markdown שנוצרה ממנה.
צילומי המסך כאן מהממשק האנגלי. באפליקציה שמוגדרת לעברית אותן פעולות מופיעות בעברית, וכך הן מצוטטות בטקסט.
יש שתי דרכים פנימה, ושתיהן מגיעות לאותו מקום. גוררים קבצים אל ה-Workspace ואזור נחיתה מקווקו נפתח מעל אזור ההערה.
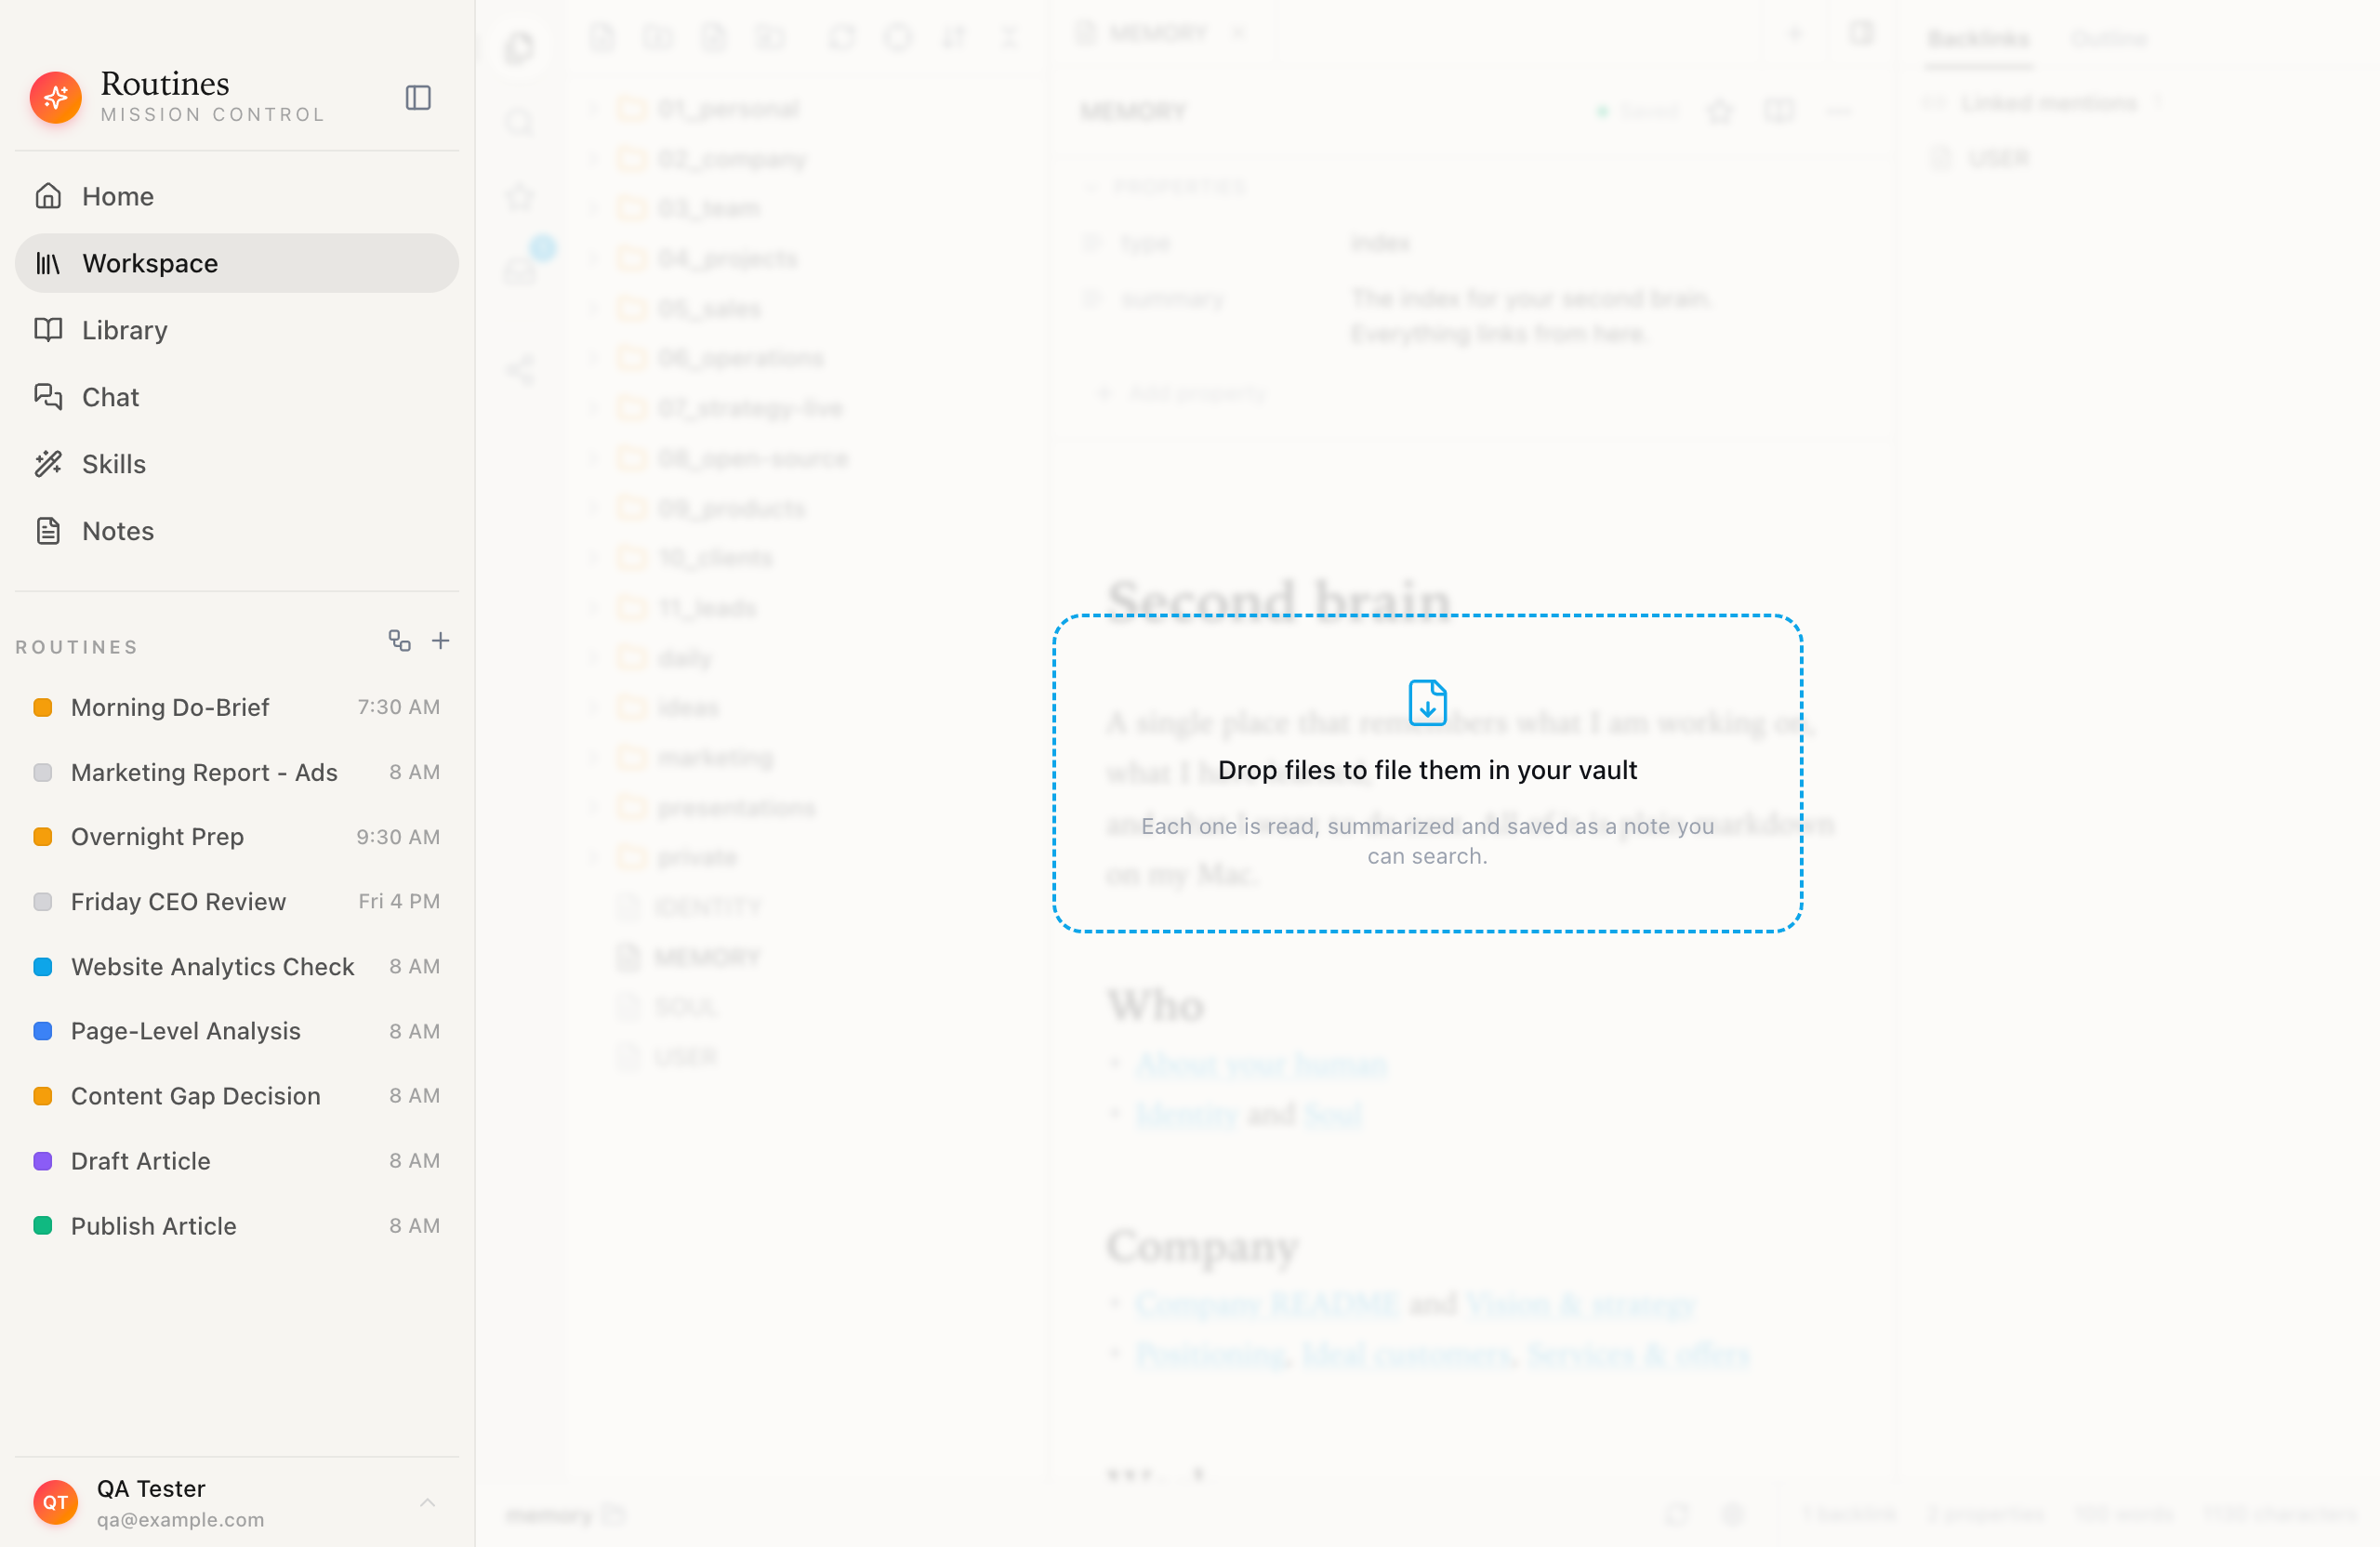
אם הגרירה מסורבלת, בסרגל הכלים של סייר הקבצים יש כפתור ״הוספת קבצים״ לצד ״פתק חדש״ ו-״תיקייה חדשה״, ולחיצה ימנית על שטח ריק בעץ מציעה את אותה פעולה בניסוח ארוך יותר: ״הוספת קבצים לזיכרון״. הבורר מקבל בחירה מרובה, כך שתיקייה שלמה של קבצים נכנסת בלחיצת Command-A אחת.
הערה על מה שהשתנה, כי המאמר הזה ותיק מהאפליקציה. פעם הייתה ל-Routines דרך כניסה שנייה, ״הוספת תיקייה״, שעברה על תיקייה לעומק כעבודת רקע שאפשר להמשיך אותה. ייבוא התיקיות הוסר בגרסה 1.5.5, ב-6.9.2026. ההערות שהוא כבר תייק נשארו בדיוק במקומן, והמסלול לכל קובץ שמתואר כאן לא השתנה. מה ש-Routines עושה עם תיקייה היום הוא דבר אחר לגמרי: בוחרים תיקייה אחת בתור תיקיית הזיכרון, בשלב האחרון של ההתקנה או אחר כך תחת הגדרות, זיכרון, והיא קוראת ומאנדקסת ברקע את ההערות שכבר נמצאות שם, בלי לכתוב מחדש שורה שכתבתם.
דעו את העלות לפני שאתם מסמנים ארבע מאות קבצים
שום דבר לא נקרא עד שאתם גוררים או בוחרים את הקבצים, ולכן גודל הבחירה הוא הערכת העלות שלכם, ברגע שאתם יודעים את החשבון. קובץ טקסט, CSV, דף אינטרנט או PDF עולים קריאת מודל אחת: הטקסט מחולץ על ה-Mac ונשלח פעם אחת כדי שיסוכם ויתויק. תמונה עולה שתיים, קריאה אחת כדי להסתכל על התמונה וקריאה שנייה כדי לסכם ולתייק את מה שיש בה, וגם התמונה עצמה נספרת בתשלום. כלומר 135 מסמכים הם בערך 135 קריאות מודל, שיורדות מקרדיט ה-AI שלכם או מחויבות למפתח שלכם, ואילו 135 צילומי מסך קרובים יותר ל-270. לדעת את החשבון הזה לפני שאתם מסמנים שולחן עבודה מלא בצילומי מסך זה ההבדל בין אצווה מודעת לבין הפתעה בחשבון.
הפורמטים הקריאים הם txt, md, markdown, json, csv, html, pdf, png, jpg, jpeg, gif ו-webp. כל דבר אחר מדולג ונשאר בשקט על הדיסק.
מה עובר על כל קובץ
כל קובץ עובר את אותו מסלול קצר, ותווית הסטטוס אומרת בדיוק איפה הוא נמצא:
- ״ממתין״. בתור. לכל היותר שני קבצים מעובדים בו זמנית, כך שהאצווה זורמת בטפטוף ולא בשיטפון. זו תקרה, לא חסינות: מול מגבלת קצב נמוכה של הספק, גם שתי קריאות במקביל יכולות להיות שתיים יותר מדי.
- ״קורא את הקובץ״. טקסט ו-markdown נקראים ישירות. קובצי PDF מוסרים את שכבת הטקסט שלהם. HTML מקולף לתוכן הקריא שלו. תמונות נשלחות למודל כתמונות, ולכן צילום מסך של דשבורד או תמונה של לוח מחיק מתוארים לפי מה שיש בהם. זה לא OCR, וזה לא דורש שבתמונה יהיה טקסט מוקלד. ההסתכלות על התמונה היא בעצמה קריאת מודל, וזאת הסיבה שתמונה עולה שתיים ומסמך עולה אחת.
- ״מסכם״. מעבר אחד של המודל מפיק כותרת, סיכום, נקודות מפתח, תגיות ותיקייה מוצעת.
- ״שומר בזיכרון״. ההערה נכתבת כ-markdown פשוט, מקושרת להערות קשורות שנמצאו בחיפוש טקסט מלא על פני ה-vault, ומתויקת. אם התיקייה שהמודל הציע היא תיקייה שכבר יש לכם, או שם ראשי חדש והגיוני אחד, היא נבחרת וההערה מתעדת שהיא תויקה אוטומטית. אחרת היא נוחתת בתיקיית ברירת המחדל שלכם, ומשם אפשר להזיז אותה.
- ״תויק״. נגמר, עם קישור להערה שנוצרה.
בחירה גדולה ממשיכה להתמלא ברקע בזמן שאתם עובדים, והמגש סופר אותה שורה אחרי שורה, כולל השורות שהייתם מעדיפים לא לראות. כשלונות גלויים תוך כדי הריצה, לא מתגלים אחריה.
כנות לגבי כישלונות היא פיצ׳ר
כל כלי שקורא ארבע מאות קבצים שרירותיים מ-Mac אמיתי ייתקל בקבצים שהוא לא מצליח לטפל בהם. השאלה היא מה הוא עושה עם זה.
Routines נכשלת בשורה אחת בכל פעם, בשפה ברורה, וממשיכה הלאה. קובץ PDF סרוק בלי שכבת טקסט נעצר עם הסיבה ״PDF contained no extractable text (it may be a scanned image)״ שנכתבת מתחת לשם שלו, ושאר האצווה ממשיכה. ההודעה הזאת מגיעה מהמנוע שקורא את הקובץ ומופיעה באנגלית גם בממשק העברי. קובץ שכבר נמצא ב-vault מסומן ״כבר קיים בזיכרון״ במקום להיות משוכפל. קובץ שהגיע כמעט עד הסוף מסומן ״תויק חלקית״ במקום להעמיד פנים שהוא שלם.
לכל מה שנגרר או נבחר יש גם בית קבוע בפאנל ״פעילות״, מאחורי סמל תיבת הדואר בסרגל השמאלי. הוא שורד מעבר בין מסכים והפעלה מחדש של האפליקציה, כי הוא קורא מאותו מסד נתונים מקומי שממנו רצה עבודת התיוק.
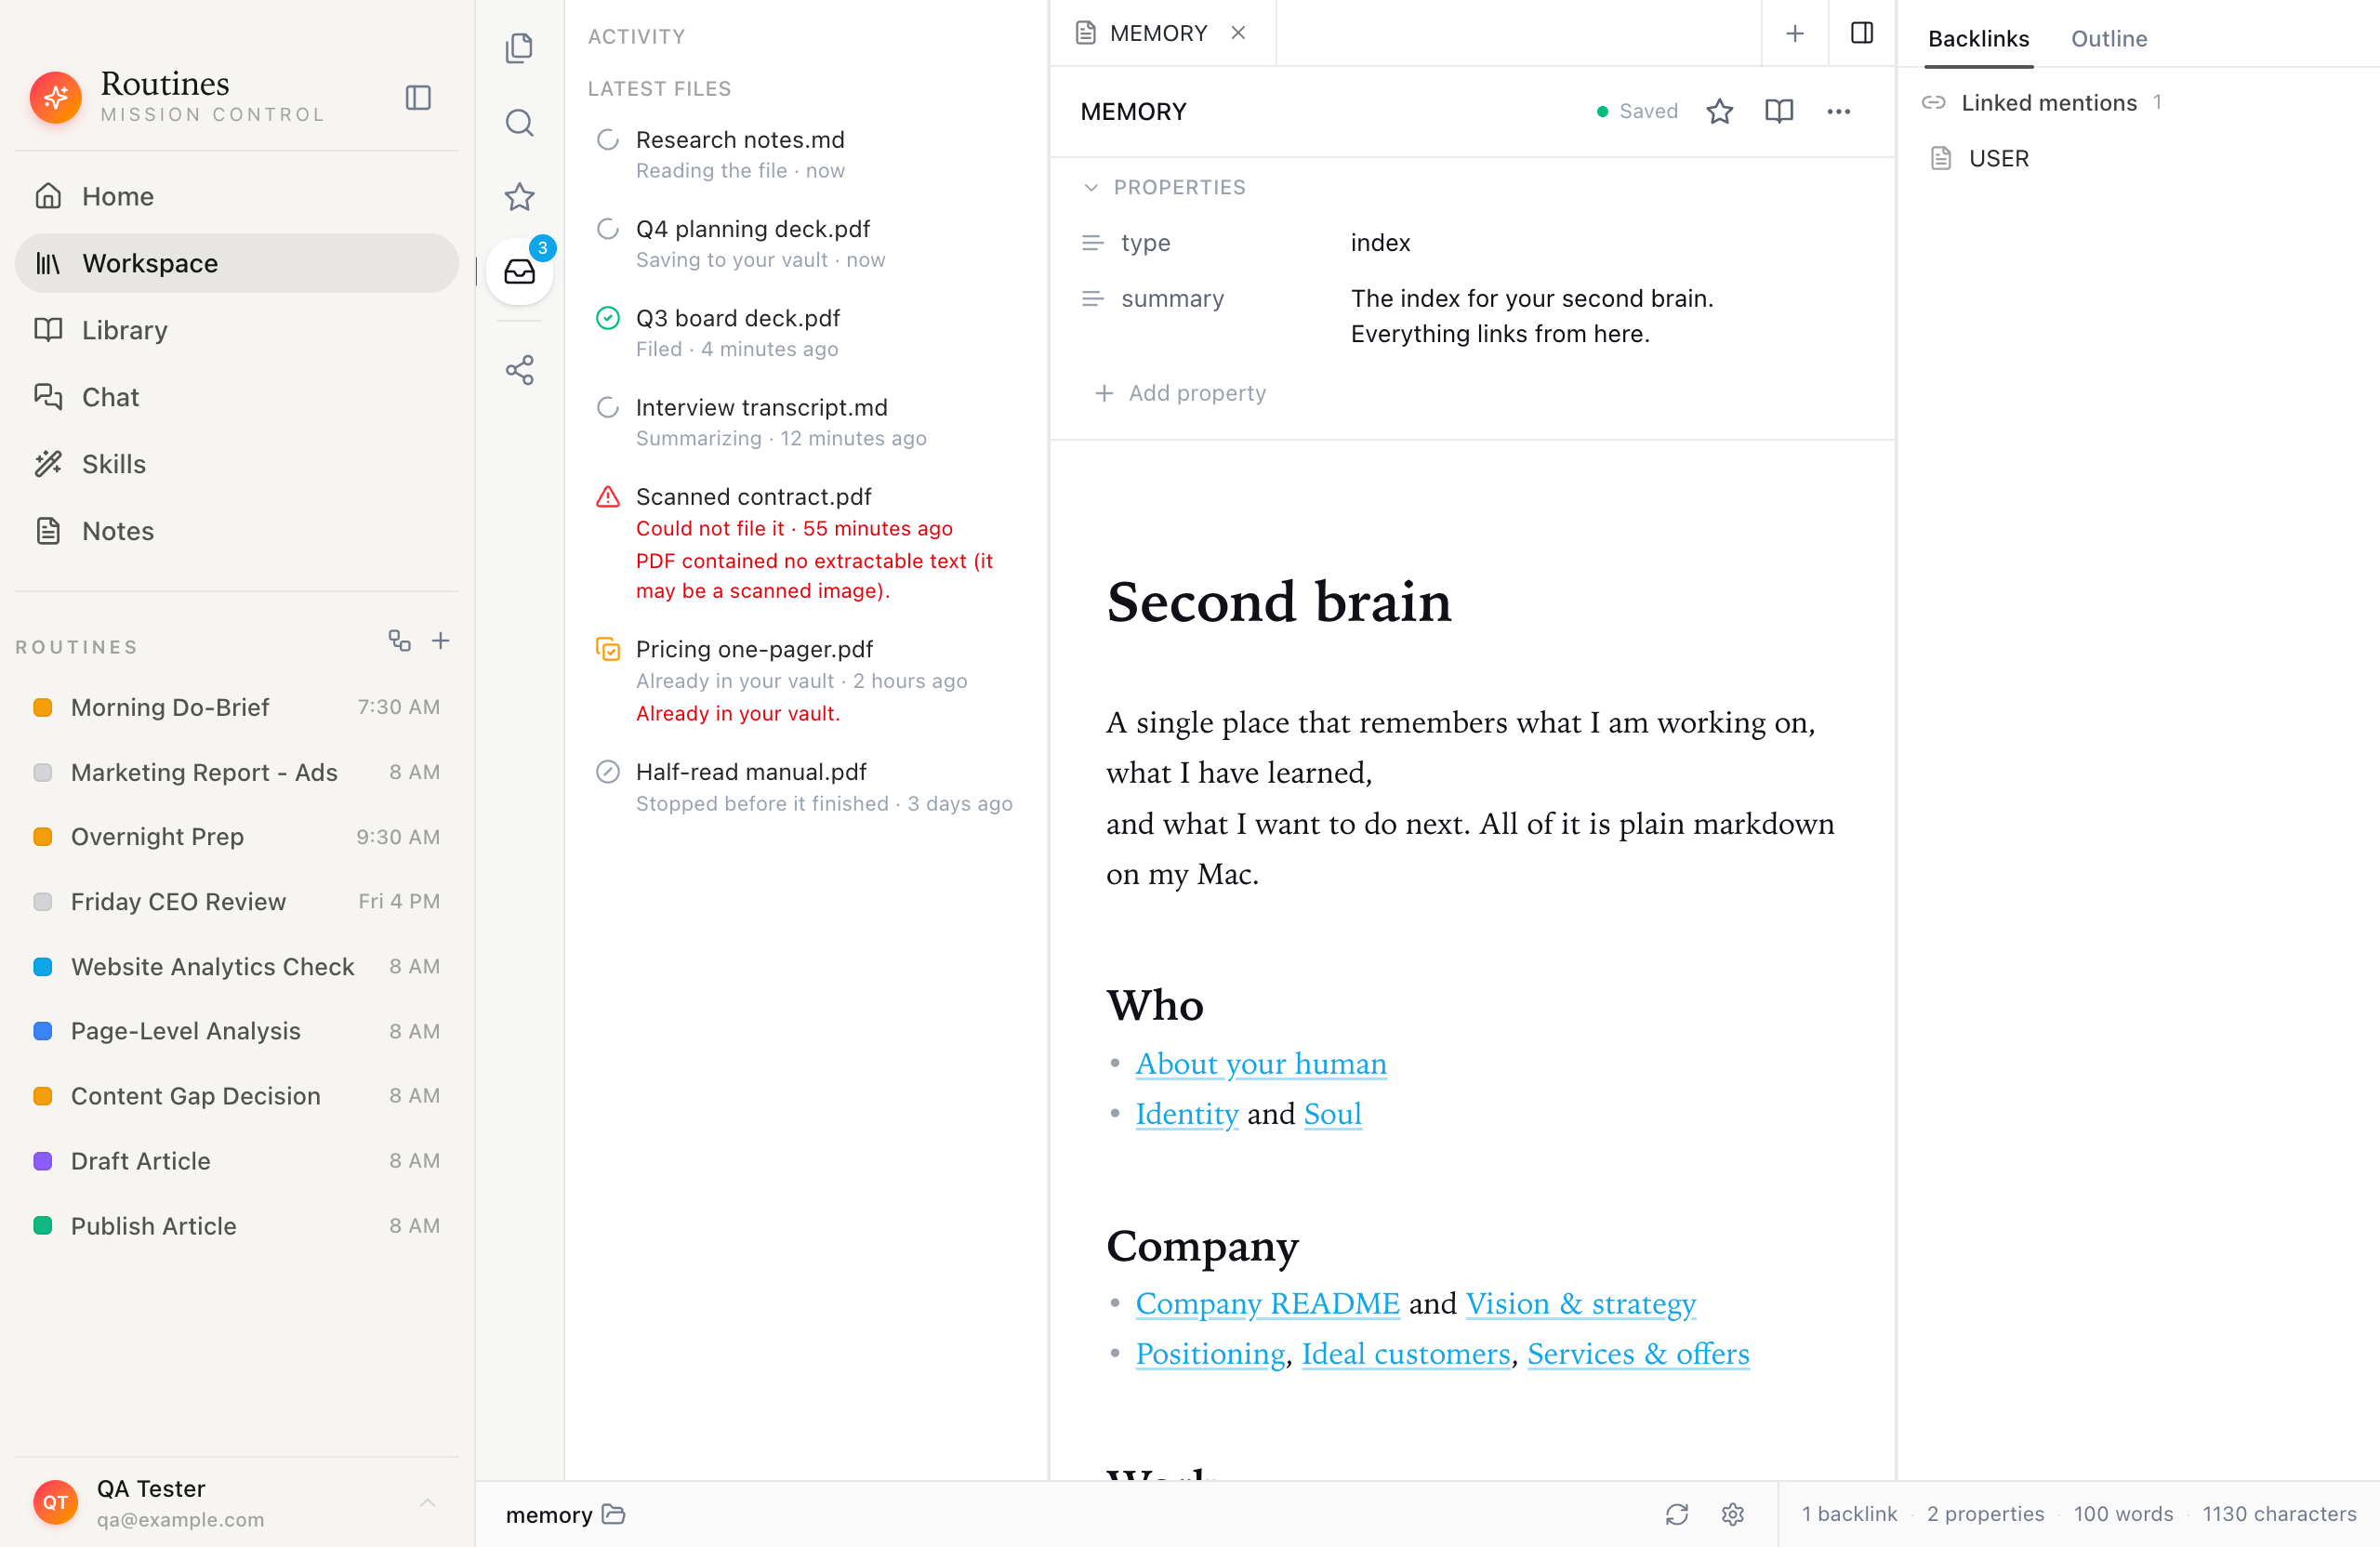
שבעה קבצים, שבע תוצאות שונות. השורה שנכשלה נושאת את הסיבה האמיתית, לא קוד שגיאה.
קובץ ששותק יותר משעה מוצג כ-״נעצר לפני הסיום״ במקום להסתובב לנצח, וזה דבר קטן שחוסך מכם לסמוך על חיווי התקדמות שמת בשקט.
לאן הקבצים באמת מגיעים, ומה עוזב את ה-Mac
החלק הזה ראוי לדיוק, כי טענות פרטיות בקטגוריה הזאת בדרך כלל מרושלות.
ה-vault שייך לכם. כל הערה היא קובץ .md פשוט בתיקייה שאתם בוחרים, עם בלוק frontmatter רגיל וטקסט קריא מתחתיו. אינדקס החיפוש הוא מסד נתונים SQLite מקומי עם חיפוש טקסט מלא. אתם יכולים לפתוח את אותה תיקייה ב-Obsidian, ב-VS Code או ב-Finder, לערוך הערה בכל אחד מהם, ו-Routines תאנדקס אותה מחדש. תגבו אותה עם הכלים שכבר יש לכם. שום דבר לא מומר לפורמט קנייני, ואתם יכולים לקחת את הכול וללכת בכל רגע.
קריאה וסיכום הם קריאת מודל, ואתם בוחרים באיזה מסלול היא נוסעת. כשקובץ נקרא ומסוכם, הטקסט שחולץ ממנו נשלח למודל, ובתמונות גם התמונה עצמה נשלחת. יש שני מסלולים ורק שניים. ב-Routines AI, שהוא מה שחשבון מחובר משתמש בו כל עוד לא הגדרתם מפתח משלכם, הבקשה יוצאת מה-Mac דרך השרת שלנו אל Anthropic. אנחנו מעבירים אותה הלאה, לא שומרים את ההנחיה ולא את התשובה, ומה שכן נשמר הוא מספר הטוקנים והעלות, כי מהם יורד קרדיט ה-AI שלכם. עם מפתח משלכם, ששמור ב-Keychain שלכם, הבקשה יוצאת מה-Mac ישירות אל הספק, Anthropic כברירת מחדל, או OpenAI או OpenRouter אם לשם הפניתם, ואין שום שרת שלנו בדרך. כך או כך תוכן הקבצים שאתם מוסיפים כן מגיע אל מודל מתארח, וזה נכון לכל כלי שמסכם מסמכים בדרך הזאת, וכך או כך אנחנו לא שומרים עותק של הקבצים שלכם. אם חלק מהחומר רגיש מדי בשביל זה, הוסיפו את השאר והשאירו את הקבצים האלה בחוץ. ה-vault עצמו נשאר על הדיסק, אלא אם תפעילו את Cloud Sync, שמשקף אותו לחשבון שלכם במכוון וכבוי עד שתבקשו אותו.
זו הצורה הכנה של העניין: אחסון מקומי מיסודו, קבצים פשוטים על הדיסק, וקריאת מודל אחת שעוברת דרך שרת שלא שומר ממנה כלום או הולכת ישירות אל הספק שלכם עם מפתח משלכם.
איך ממשיכים להאכיל אותו אחרי האצווה הראשונה
הבחירה הגדולה היא החלק החד פעמי. מוח שני שמחזיק רק את מה שהיה לכם באוגוסט הוא תצלום מצב, לא מערכת.
- גררו קבצים בודדים כשהם מגיעים. חוזה, מצגת שמישהו שלח, צילום מסך ששווה לשמור. גרירה אחת, והוא מתויק ומקושר כמו כל השאר.
- תנו לשגרות לכתוב פנימה. שגרות מתוזמנות יכולות להוסיף ל-vault בעצמן. אוסף החשבוניות והקבלות שולף חשבוניות מהתיבה שלכם כל חודש, ו-תיוק הערות פגישה שם את הסיכום של כל פגישה איפה שהוא צריך להיות במקום בערימה.
- דברו במקום להקליד. אם חיכוך התיעוד הוא הבעיה האמיתית שלכם, הכתבה במקש קיצור מכניסה מחשבה להערה מהר יותר מפתיחת עורך.
זה שונה מסתם לבחור אפליקציית מוח שני?
זו שאלה אחרת, לא תשובה טובה יותר. הבחירה בין Notion, Obsidian, Logseq והשאר היא שאלה על איפה ההערות שלכם צריכות לחיות, ושווה לענות עליה ברצינות. השווינו ביניהן ב-אפליקציות המוח השני הטובות ביותר, כולל הפשרות שבהן הכלים הקלאסיים מנצחים בבירור.
המאמר הזה עונה על השאלה השנייה: איך ההערות בכלל נכתבות מלכתחילה, כשכבר יש לכם שנים של חומר ואין מסלול מציאותי לעבד אותו ביד. אם בחרתם ב-Obsidian ואתם אוהבים אותה, תישארו איתה. הפכו את אותה תיקיית vault לתיקיית הזיכרון של Routines וגררו לתוכה חומר חדש. השתיים לא מתחרות על אותה עבודה.
איך מתחילים
הסיבה שרוב המוחות השניים נכשלים היא לא האפליקציה. היא שהפער בין ״הקבצים שיש לי״ לבין ״הערות שאפשר לחפש בהן״ נמדד בעשרות שעות שאין לאף אחד.
הורידו את Routines ופתחו את תיקיית Downloads, כי היא הדבר הכי מבולגן שיש לכם. סמנו את עשרים הקבצים שהייתם באמת רוצים בחזרה יום אחד, גררו אותם אל ה-Workspace, ותנו להם לתייק את עצמם ברקע בזמן שאתם עושים משהו אחר. ההערות שהיא כותבת נפתחות בכל עורך markdown. שבעה ימים בחינם, בלי כרטיס אשראי.
שאלות נפוצות
מהו מוח שני מבוסס AI?
מאגר ידע דיגיטלי שבו ה-AI עושה בשבילכם את עבודת הארגון: קורא כל פריט, מסכם אותו, מתייג אותו, מקשר אותו להערות קשורות ומתייק אותו לתיקייה הנכונה. שיטת המוח השני הקלאסית מבקשת שתעשו את השלבים האלה ביד, ובדיוק בגלל זה רוב ה-vaults מתיישנים. הגרסה עם ה-AI ממשיכה לעבוד גם כשהמשמעת שלכם נגמרת.
אני חייב להתחיל מאפס, או שאפשר להשתמש בקבצים שכבר יש לי?
אפשר להתחיל ממה שיש. סמנו את קובצי ה-PDF, צילומי המסך, קובצי הטקסט, הייצואים או ההערות הישנות שכבר על ה-Mac, גררו אותם אל ה-Workspace, וכל קובץ נקרא, מסוכם, מתויג, מקושר ונשמר כהערת markdown. אין שלב הגירה ואין פורמט קנייני.
אפשר להוסיף הרבה קבצים בבת אחת, ולא קובץ אחרי קובץ?
כן. גוררים בחירה שלמה אל ה-Workspace, או בוחרים ״הוספת קבצים״ ומסמנים כמה שרוצים בבורר, וכל הקבצים נכנסים לאותו מגש תיוק. כל אחד נקרא, מסוכם, מתויג ומתויק בשורה משלו, כך שכישלון בקובץ אחד לא עוצר את השאר. Routines כבר לא עוברת בשבילכם על תיקייה שלמה לעומק: ייבוא התיקיות הוסר בגרסה 1.5.5, וההערות שהוא כבר תייק נשארו במקומן.
מה ההבדל בין הוספת קבצים לבין בחירת תיקיית זיכרון?
הוספת קבצים היא המסלול שבמאמר הזה: כל קובץ נקרא, מסוכם, מתויג ונכתב לזיכרון כהערת markdown חדשה. בחירת תיקיית זיכרון, בשלב האחרון של ההתקנה או אחר כך תחת הגדרות, זיכרון, מפנה את Routines להערות שכבר יש לכם. הבחירה מיידית, הקריאה והאינדוקס רצים ברקע, ושום דבר שכתבתם לא נכתב מחדש.
היא יודעת לקרוא צילומי מסך ומסמכים סרוקים?
בתמונות PNG, JPEG, GIF ו-WebP המודל מסתכל על התמונה עצמה במקום להריץ OCR, ולכן צילום מסך של דשבורד או תמונה של לוח מחיק הופכים לסיכום אמיתי. בקובצי PDF היא מחלצת את שכבת הטקסט. קובץ PDF סרוק בלי שכבת טקסט נכשל בשורה שלו עם הסיבה שלא נמצא בו טקסט לחילוץ וייתכן שמדובר בסריקה, ושאר האצווה ממשיכה כרגיל.
אני צריך את Obsidian כדי להשתמש בזה?
לא, אבל השתיים עובדות יחד. ה-vault הוא תיקייה רגילה של קובצי markdown, ולכן אפשר להפנות את Routines אל vault קיים של Obsidian ולהמשיך לערוך ב-Obsidian. שום דבר לא מומר ושום דבר לא ננעל.
מוח שני שנבנה ככה הוא פרטי?
ה-vault שלכם הוא markdown פשוט בתיקייה שאתם בוחרים, עם אינדקס SQLite מקומי, והוא נשאר על הדיסק אלא אם תפעילו בעצמכם את Cloud Sync. שלב הקריאה והסיכום צריך מודל מתארח, ולכן תוכן הקבצים שאתם מוסיפים כן מגיע לאחד, ואתם בוחרים את המסלול: Routines AI מעבירה את הבקשה דרך השרת שלנו אל Anthropic ולא שומרת לא את ההנחיה ולא את התשובה, או שאתם נכנסים עם המנוי ל-Claude או ל-ChatGPT שכבר יש לכם, או מגדירים מפתח API משלכם, והבקשה יוצאת מה-Mac ישירות אל הספק בלי שום שרת שלנו בדרך. כך או כך אנחנו לא שומרים עותק של הקבצים שלכם. אם חלק מהחומר רגיש מדי בשביל זה, הוסיפו את השאר והשאירו את הקבצים האלה בחוץ.
כמה זמן באמת לוקח להגיע למוח שני שימושי?
לתייק 400 קבצים ביד זה בערך 30 עד 60 שעות של קריאה והקלדה. אצווה שנגררה אל ה-Workspace רצה לבד ברקע בזמן שאתם עובדים, ואפשר לחפש בתוצאות כבר כשהקבצים הראשונים נוחתים. הגבול האמיתי הוא ההוצאה על ה-AI והחיבור שלכם, לא היומן.